芯片原理
一、半导体基础与芯片设计
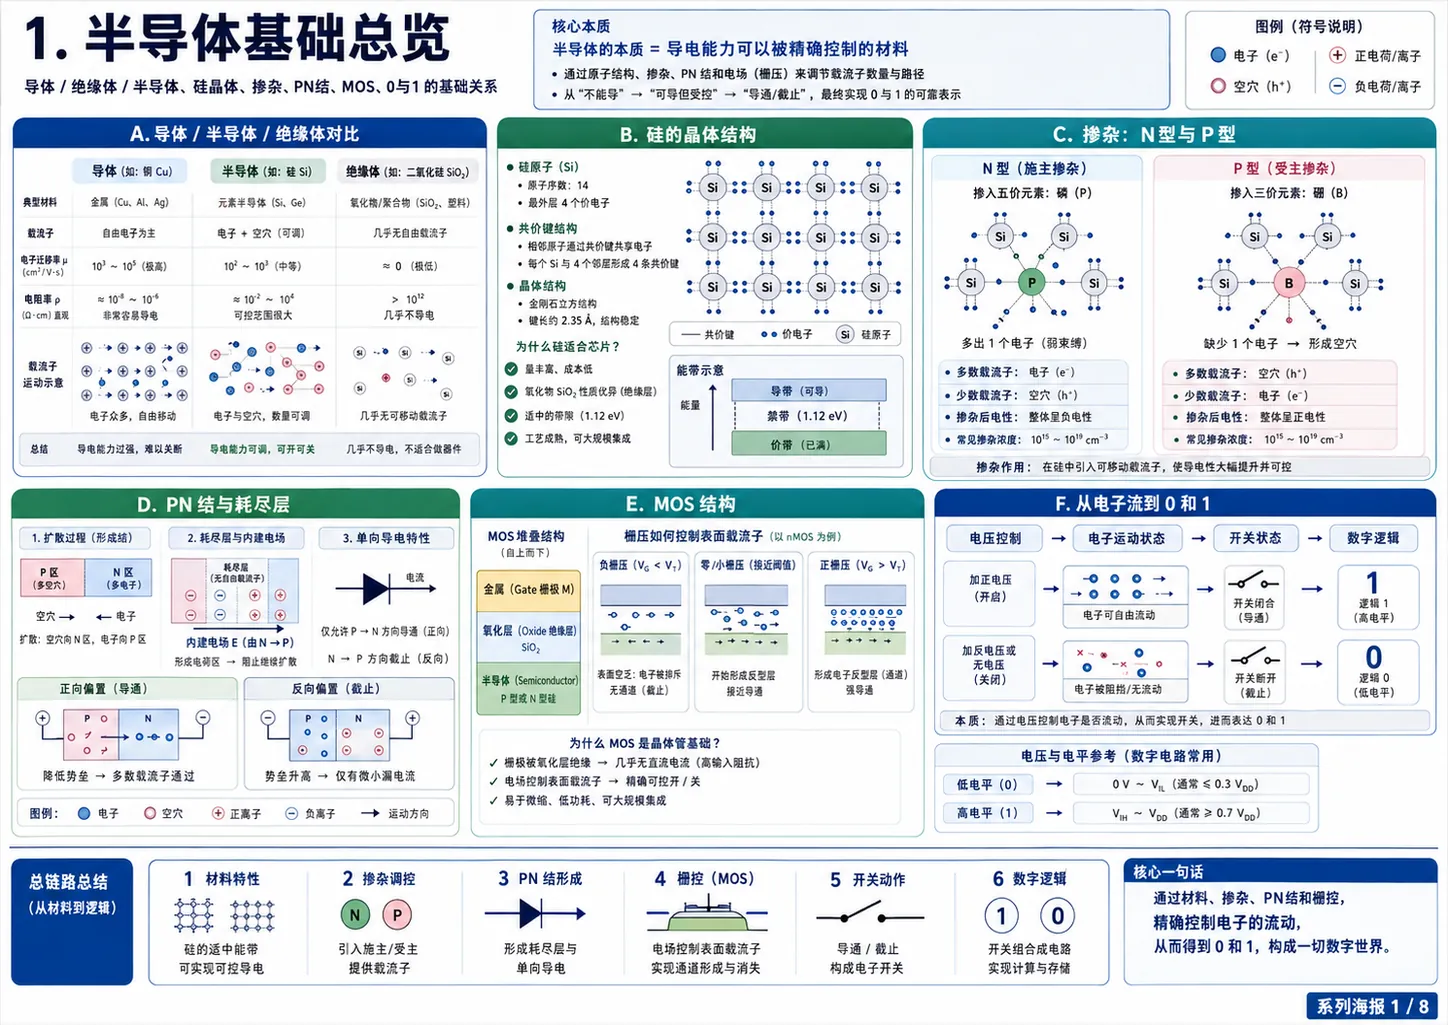
半导体基础总览:从导体、半导体和绝缘体的区别出发,理解硅材料、掺杂、PN 结、MOS 管及数字逻辑之间的关系。
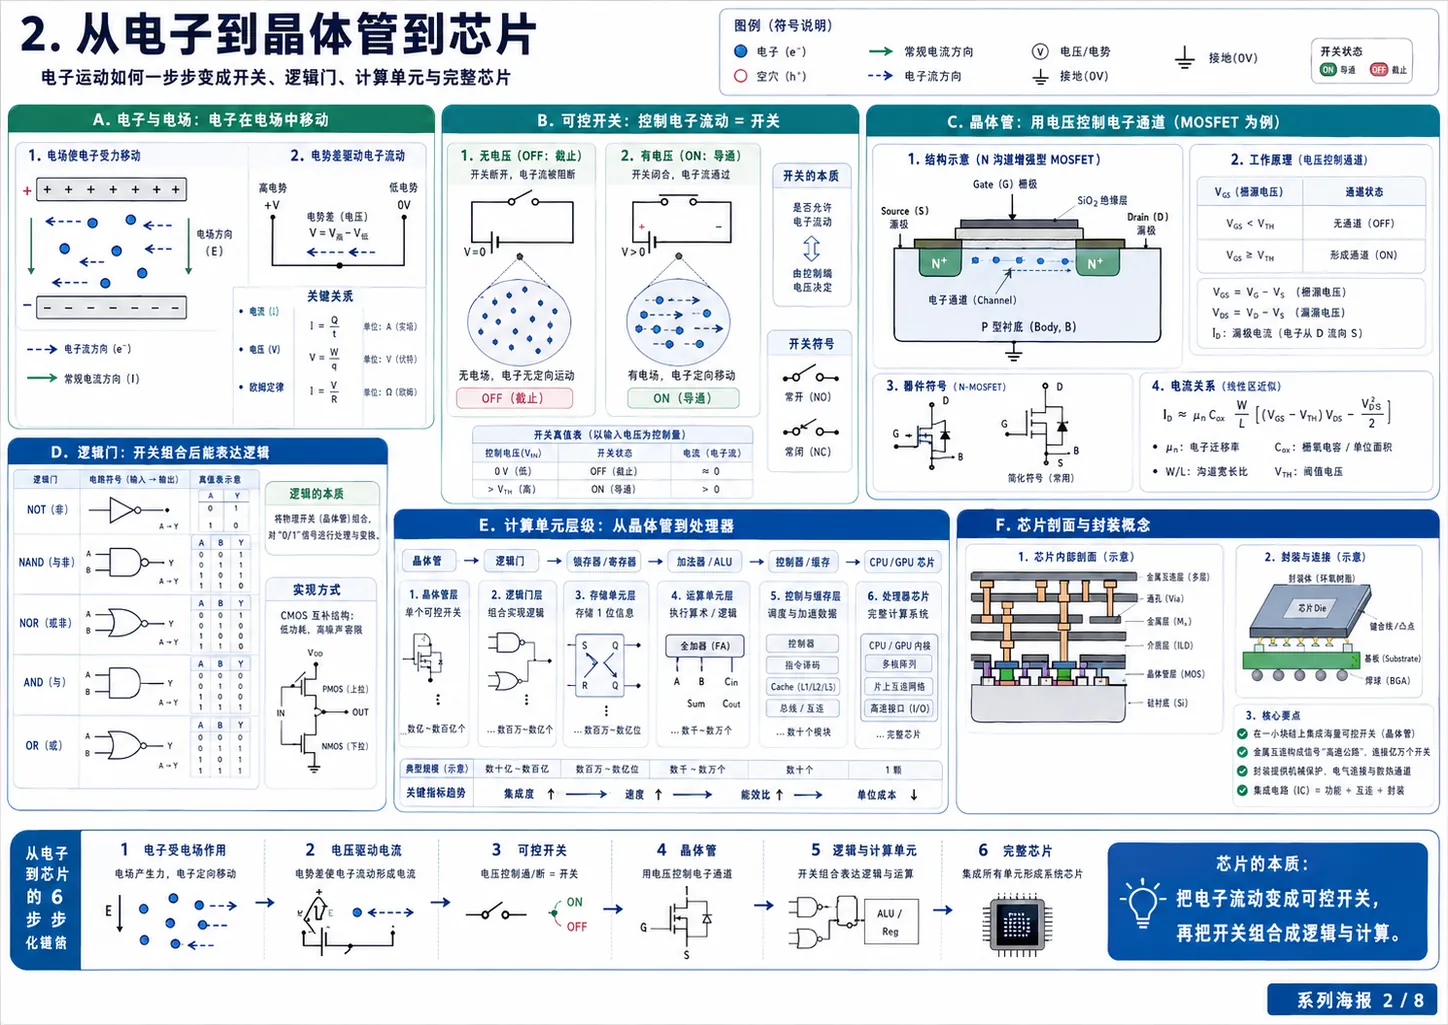
从电子到晶体管再到芯片:沿着电子运动、开关器件、逻辑门、寄存器和处理器的层级,理解芯片如何完成计算。
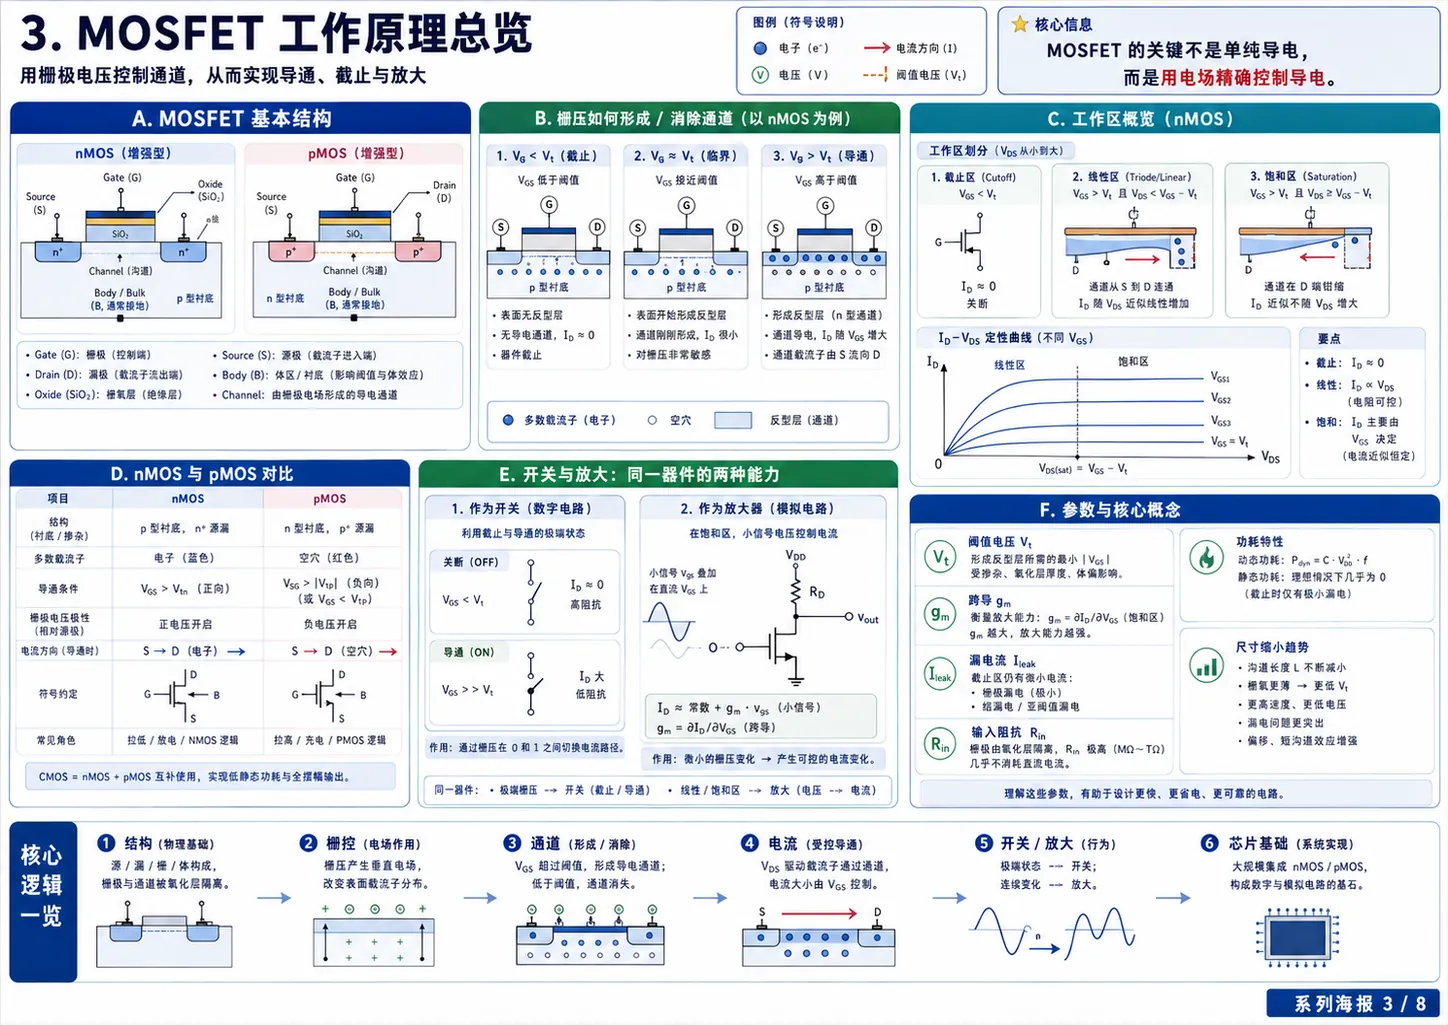
MOSFET 工作原理:通过栅极电压控制沟道的形成与关闭,并用截止、线性和饱和三个区域描述其工作状态。
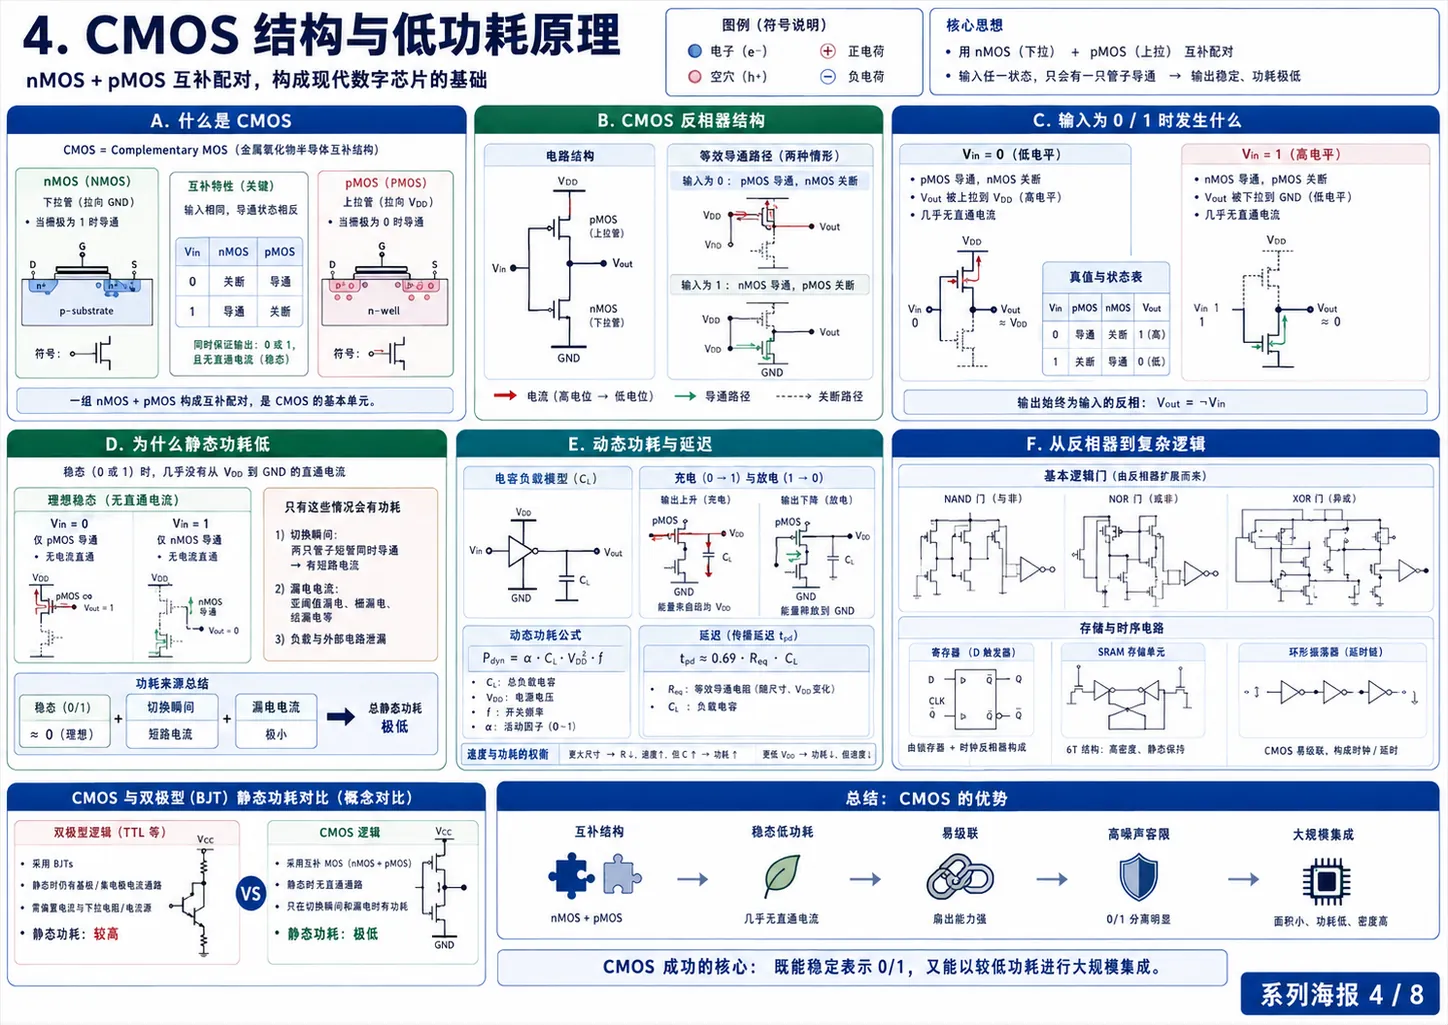
CMOS 结构与低功耗原理:利用 nMOS 与 pMOS 互补导通,使电路主要在状态切换时产生动态功耗。
|
|
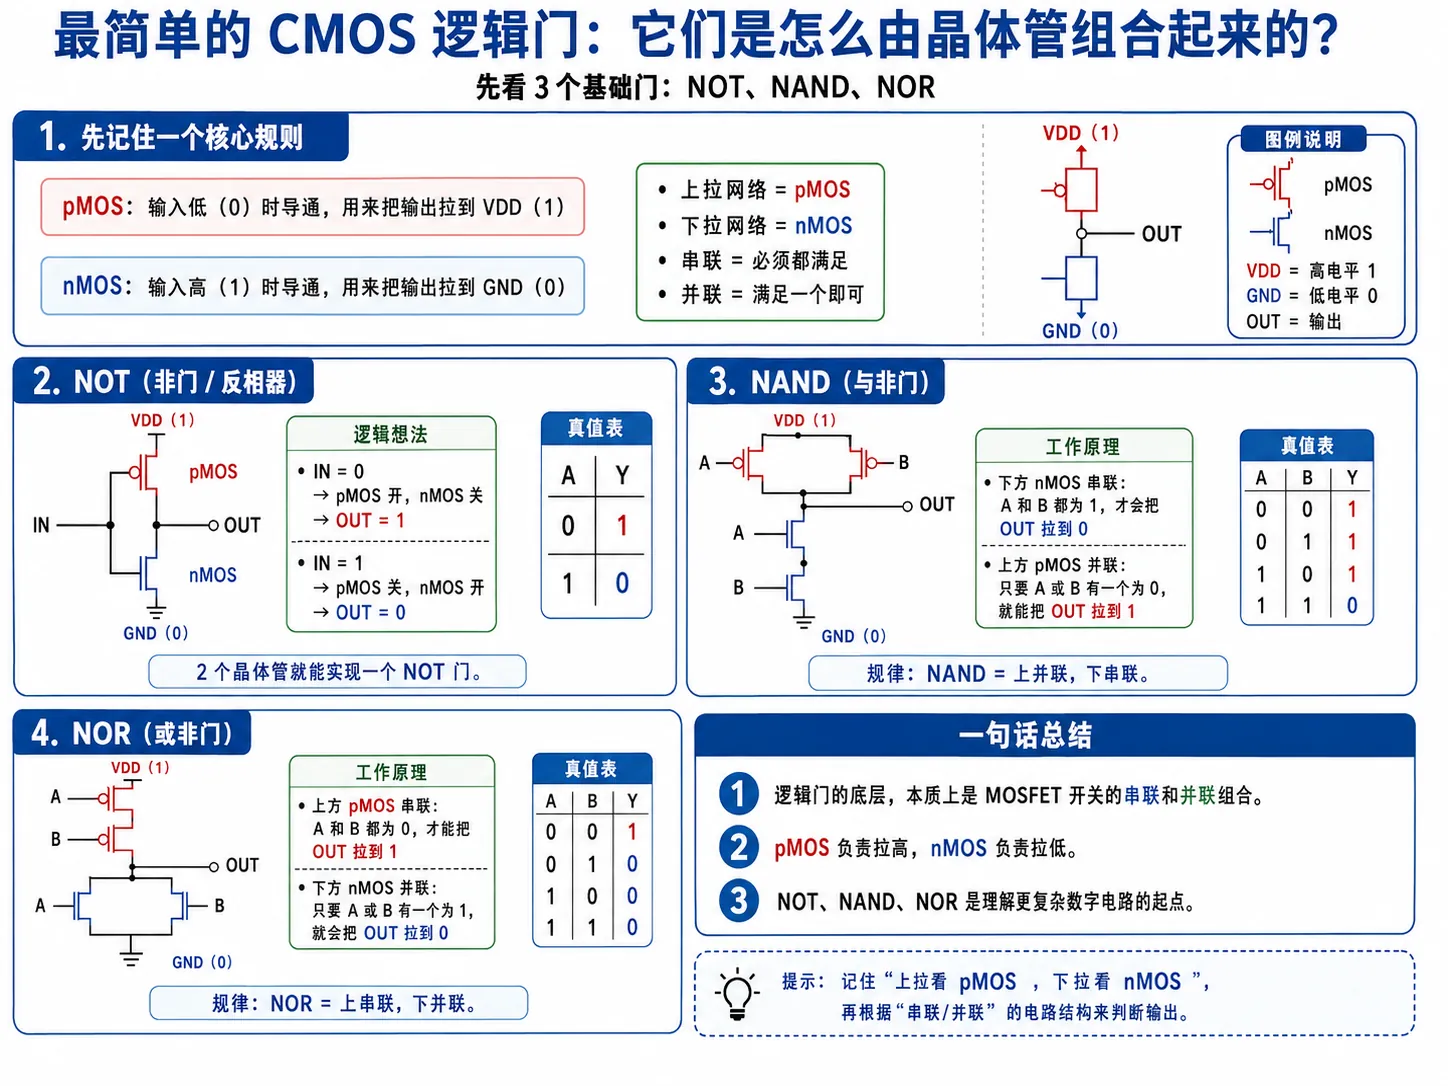
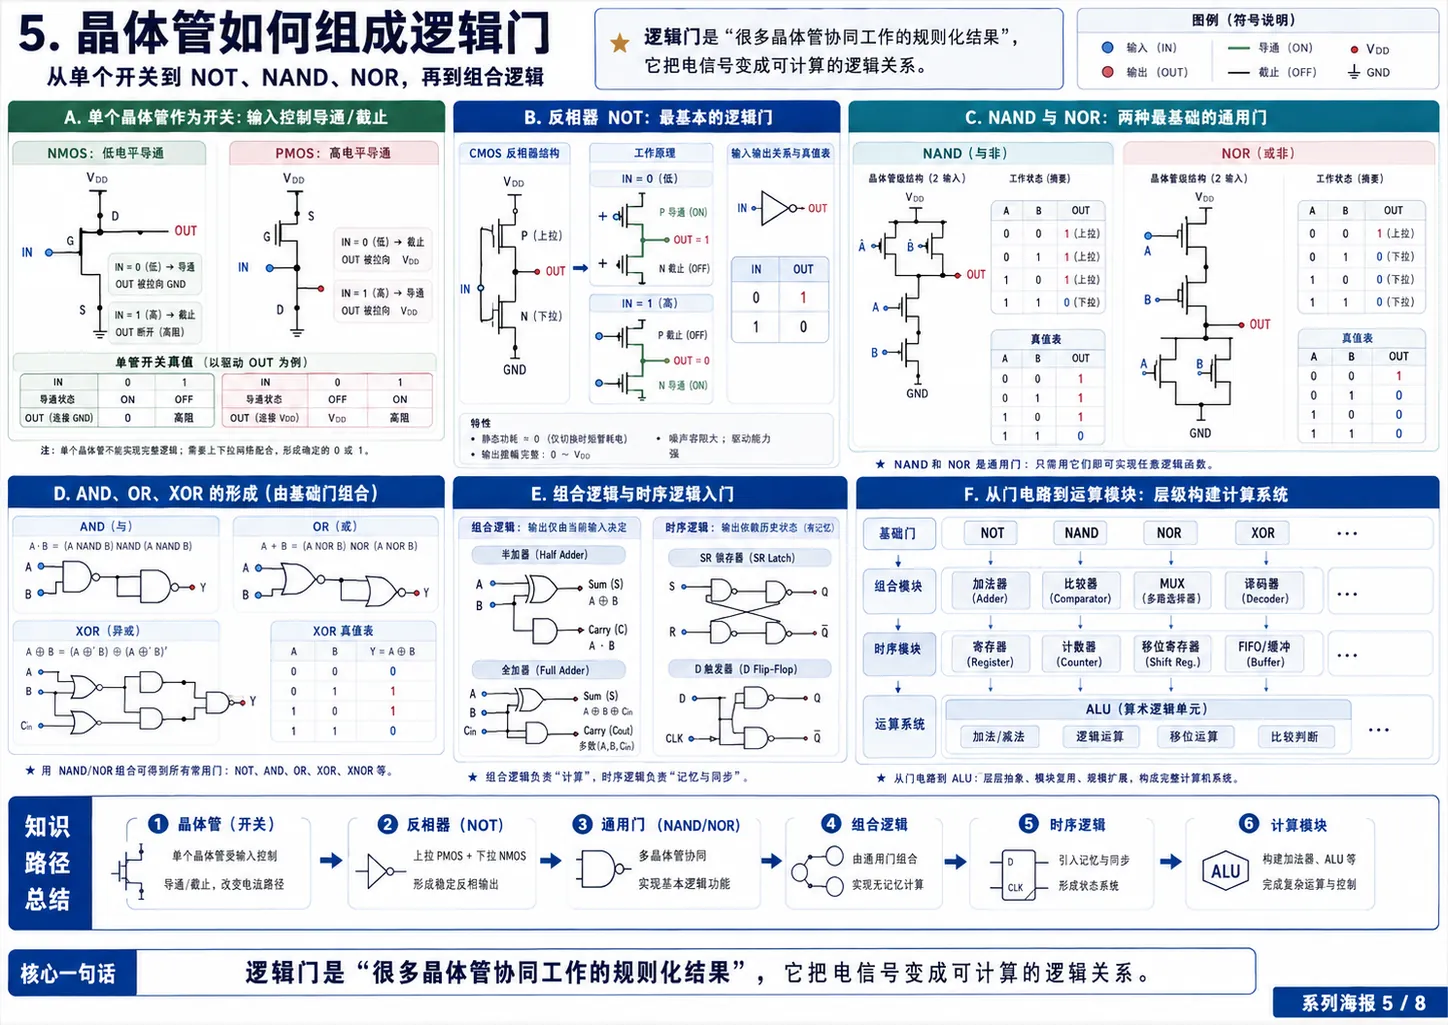
晶体管组成逻辑门:通过不同的串并联组合构造 NOT、NAND、NOR、AND、OR 和 XOR,并进一步搭建时序与计算电路。
|
|
XOR 实现
|
|
优化后的 xor
flowchart LR
    A[A] --> N1["NAND<br/>X = ~(A·B)"]
    B[B] --> N1

    A --> N2["NAND<br/>P = ~(A·X)"]
    N1 --> N2

    B --> N3["NAND<br/>Q = ~(B·X)"]
    N1 --> N3

    N2 --> N4["NAND<br/>Y = ~(P·Q)"]
    N3 --> N4

    N4 --> Y["XOR 输出 Y"]
按最经典的静态 CMOS 实现来数
- 1 个 pMOS = 1 个晶体管
- 1 个 nMOS = 1 个晶体管
| 逻辑门 | 典型 CMOS 晶体管数 |
|---|---|
| NOT | 2 |
| NAND | 4 |
| NOR | 4 |
| AND | 6 |
| OR | 6 |
半加器
|
|
全加器
- SUM:当前这一位的计算结果
- COUT:向更高一位产生的进位。
flowchart LR
    A[A] --> XOR1[XOR]
    B[B] --> XOR1
    XOR1 -->|X = A XOR B| XOR2[XOR]
    Cin[Cin] --> XOR2
    XOR2 --> SUM[SUM]

    A --> AND1[AND]
    B --> AND1
    AND1 -->|C1 = A AND B| OR1[OR]

    XOR1 --> AND2[AND]
    Cin --> AND2
    AND2 -->|C2 = X AND Cin| OR1

    OR1 --> COUT[COUT]
再把很多个全加器串起来,就能算多位二进制:
|
|
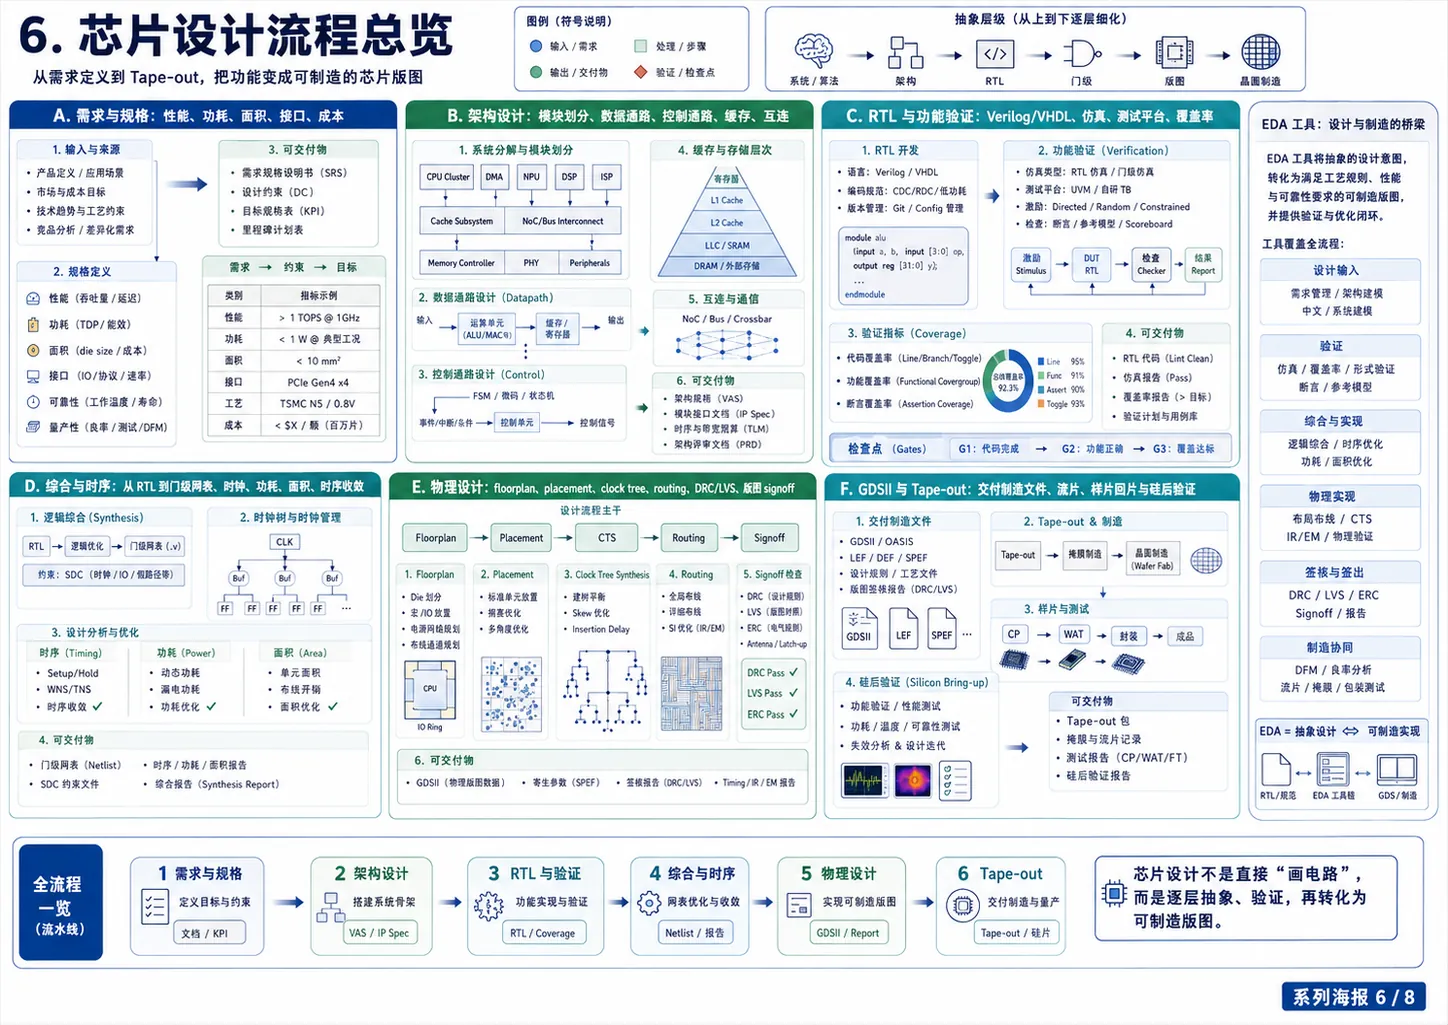
芯片设计流程:从需求规格、架构设计和 RTL 编码,经过验证、综合、布局布线与签核,最终生成 Tape-out 数据。
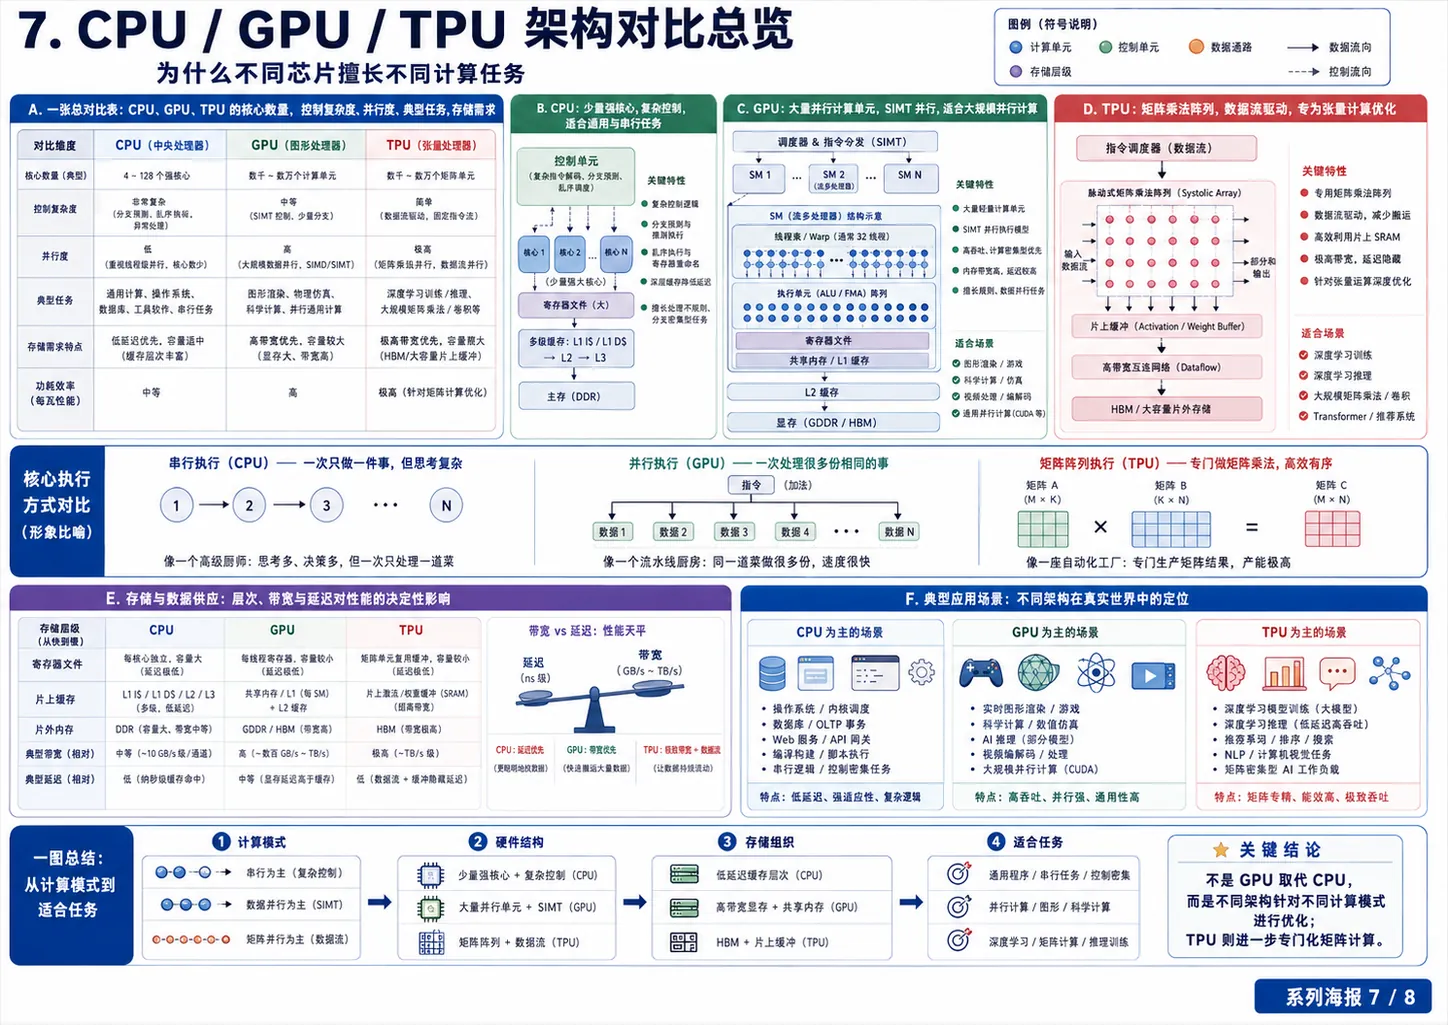
CPU、GPU 与 TPU 架构对比:CPU 擅长通用控制,GPU 强于大规模并行,而 TPU 面向矩阵计算进行专用优化。
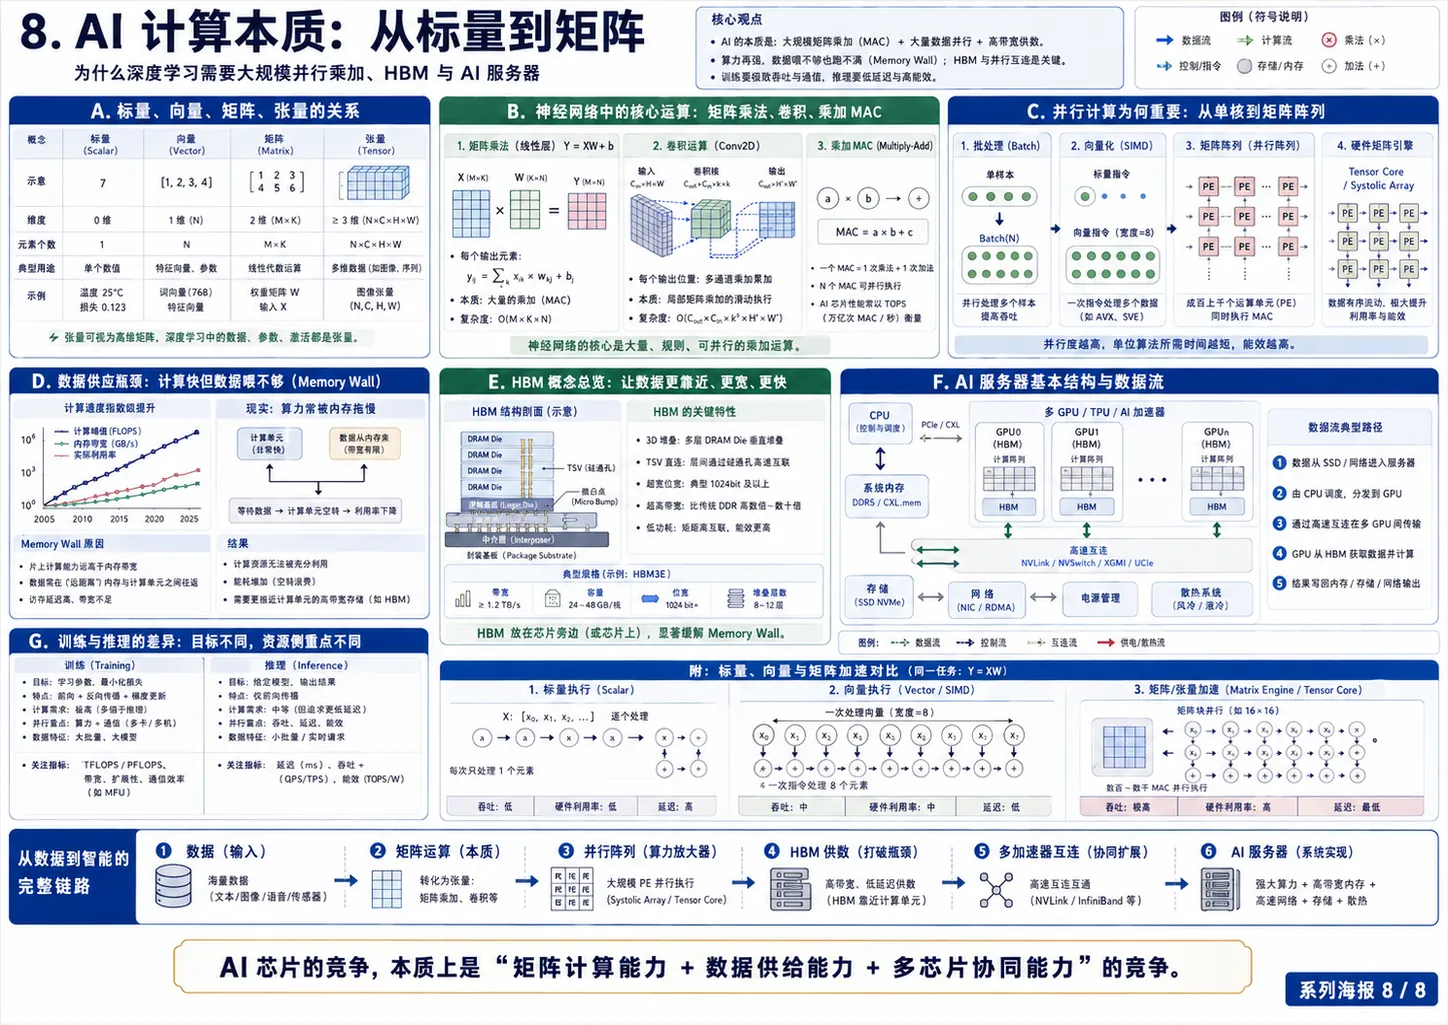
AI 计算的本质:神经网络训练与推理可以归结为大量矩阵乘加,以及围绕算力、显存带宽和数据搬运的协同优化。
二、晶圆制造与光刻
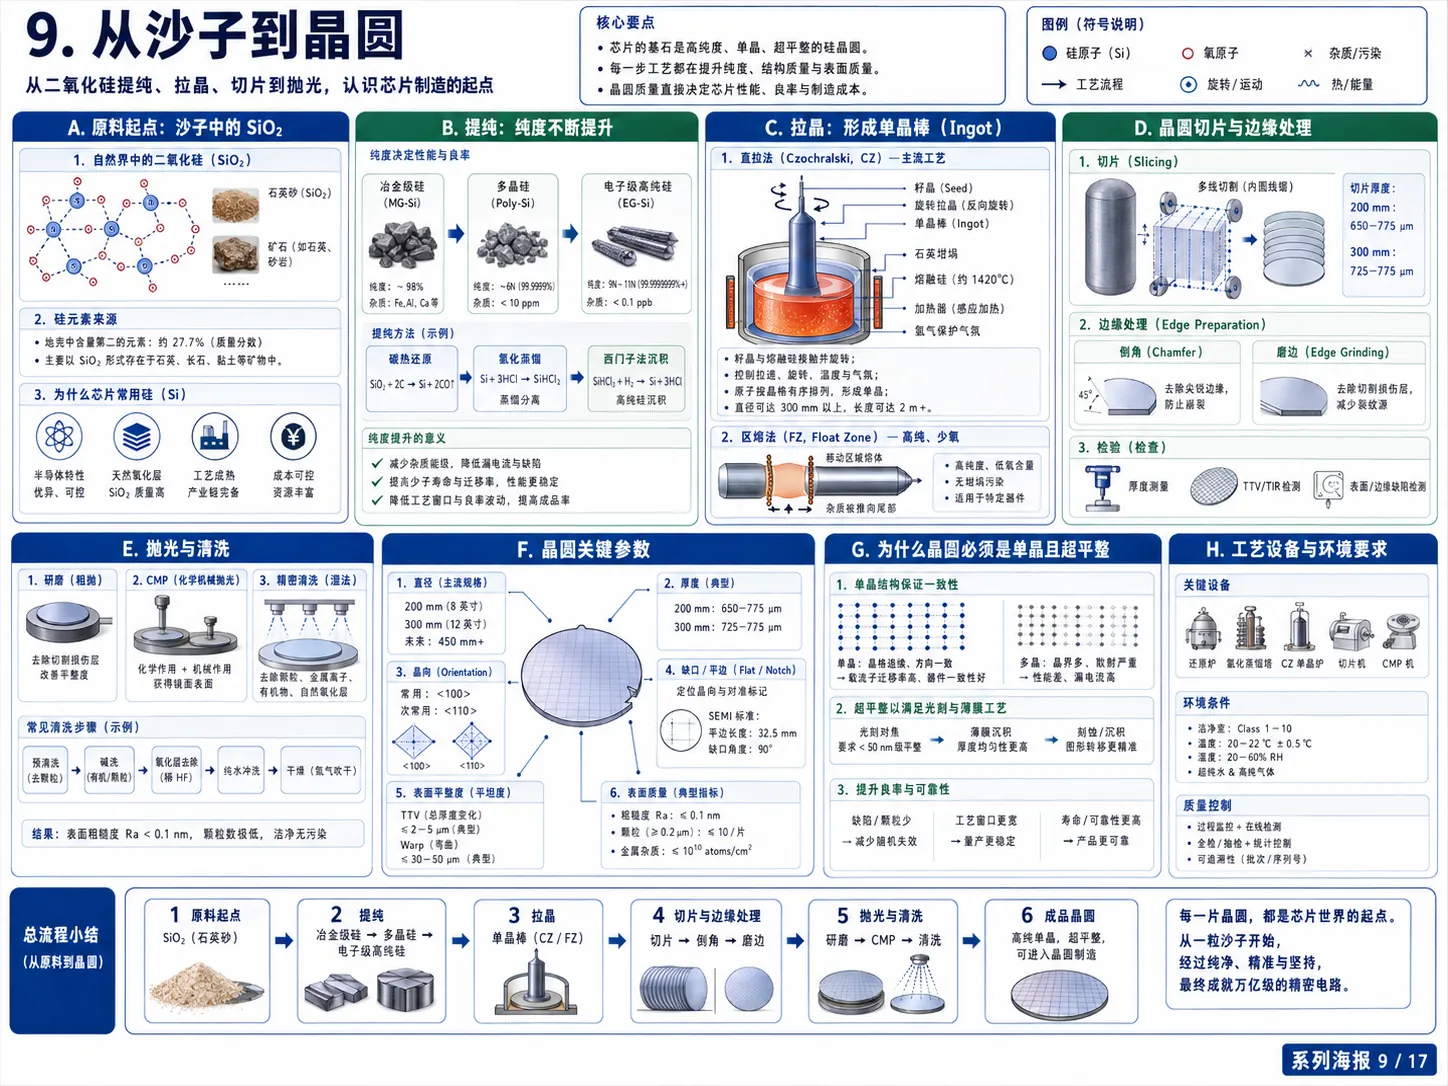
从沙子到晶圆:高纯石英经过提纯、拉晶、切片、研磨和清洗,最终形成满足芯片制造要求的单晶硅片。
晶圆制造总流程:芯片通过 FEOL、MOL 与 BEOL 中反复进行薄膜、光刻、刻蚀、注入和互连,逐层构建完整电路。
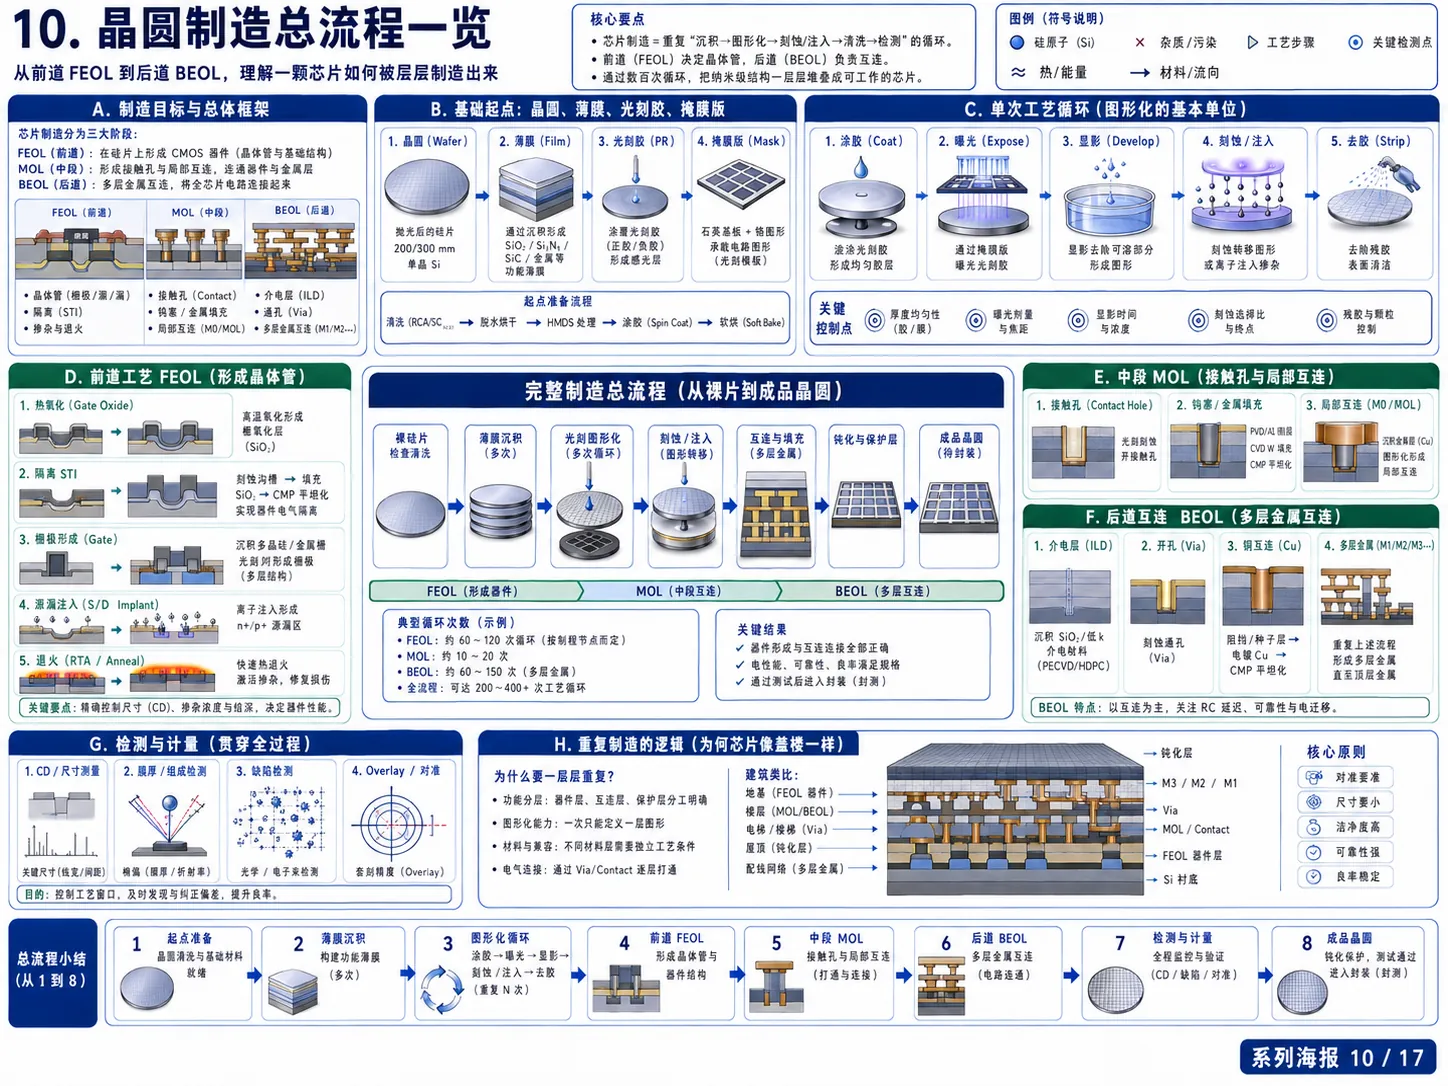
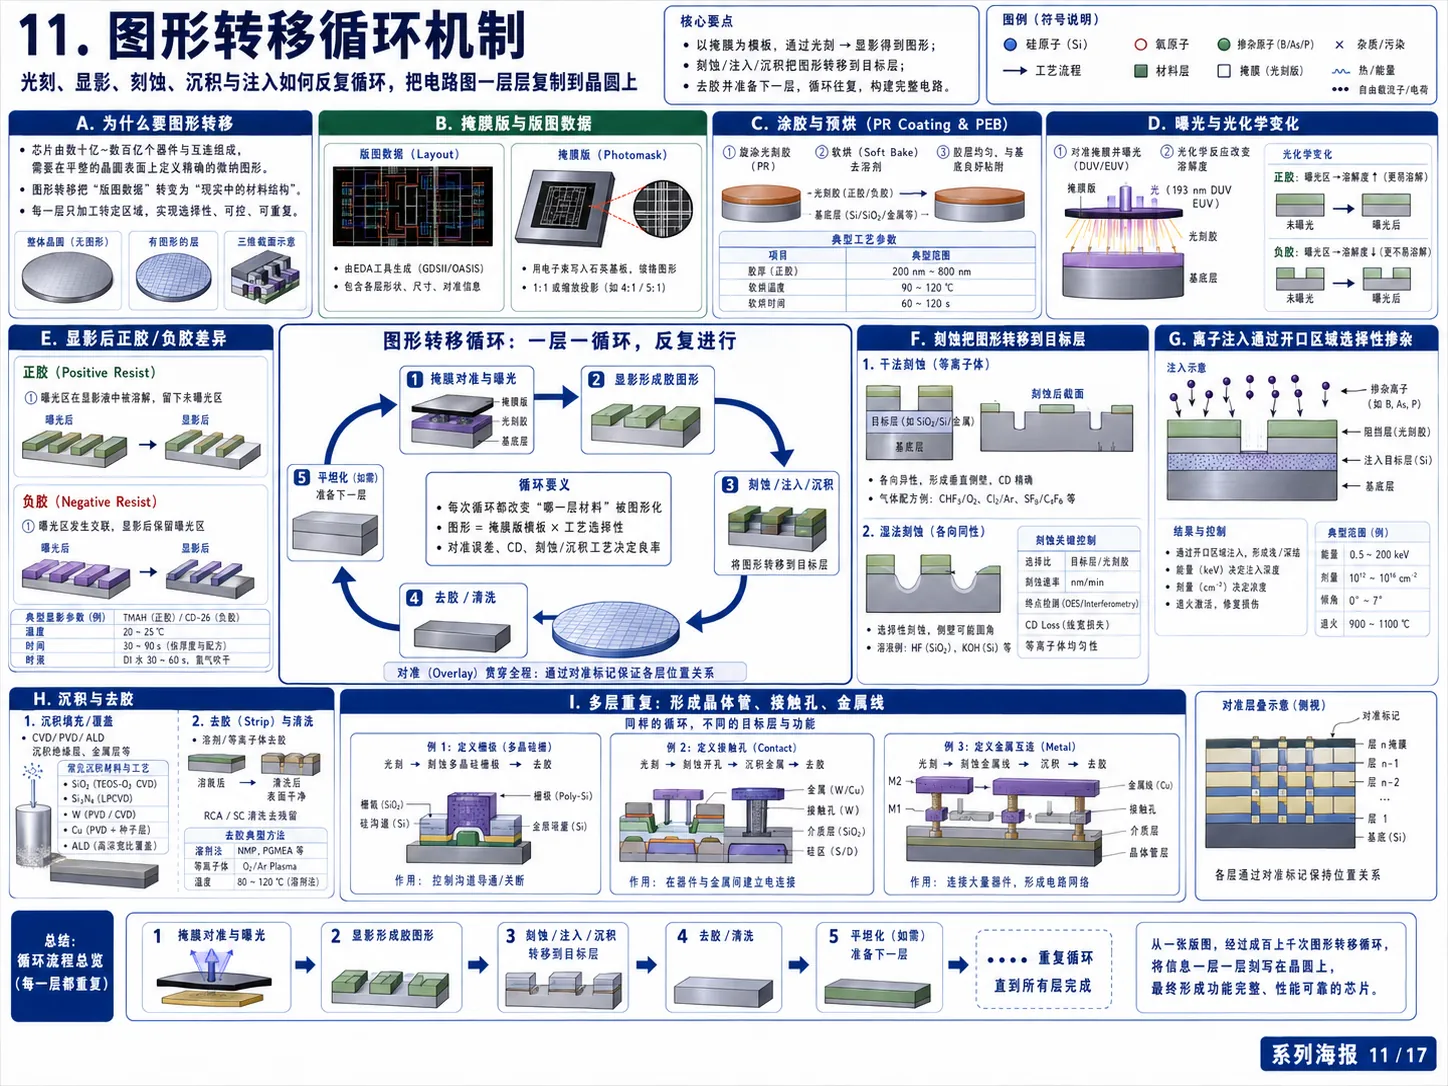
图形转移循环:涂胶、曝光、显影、刻蚀或注入、去胶等步骤不断重复,把掩膜版图形逐层复制到晶圆上。
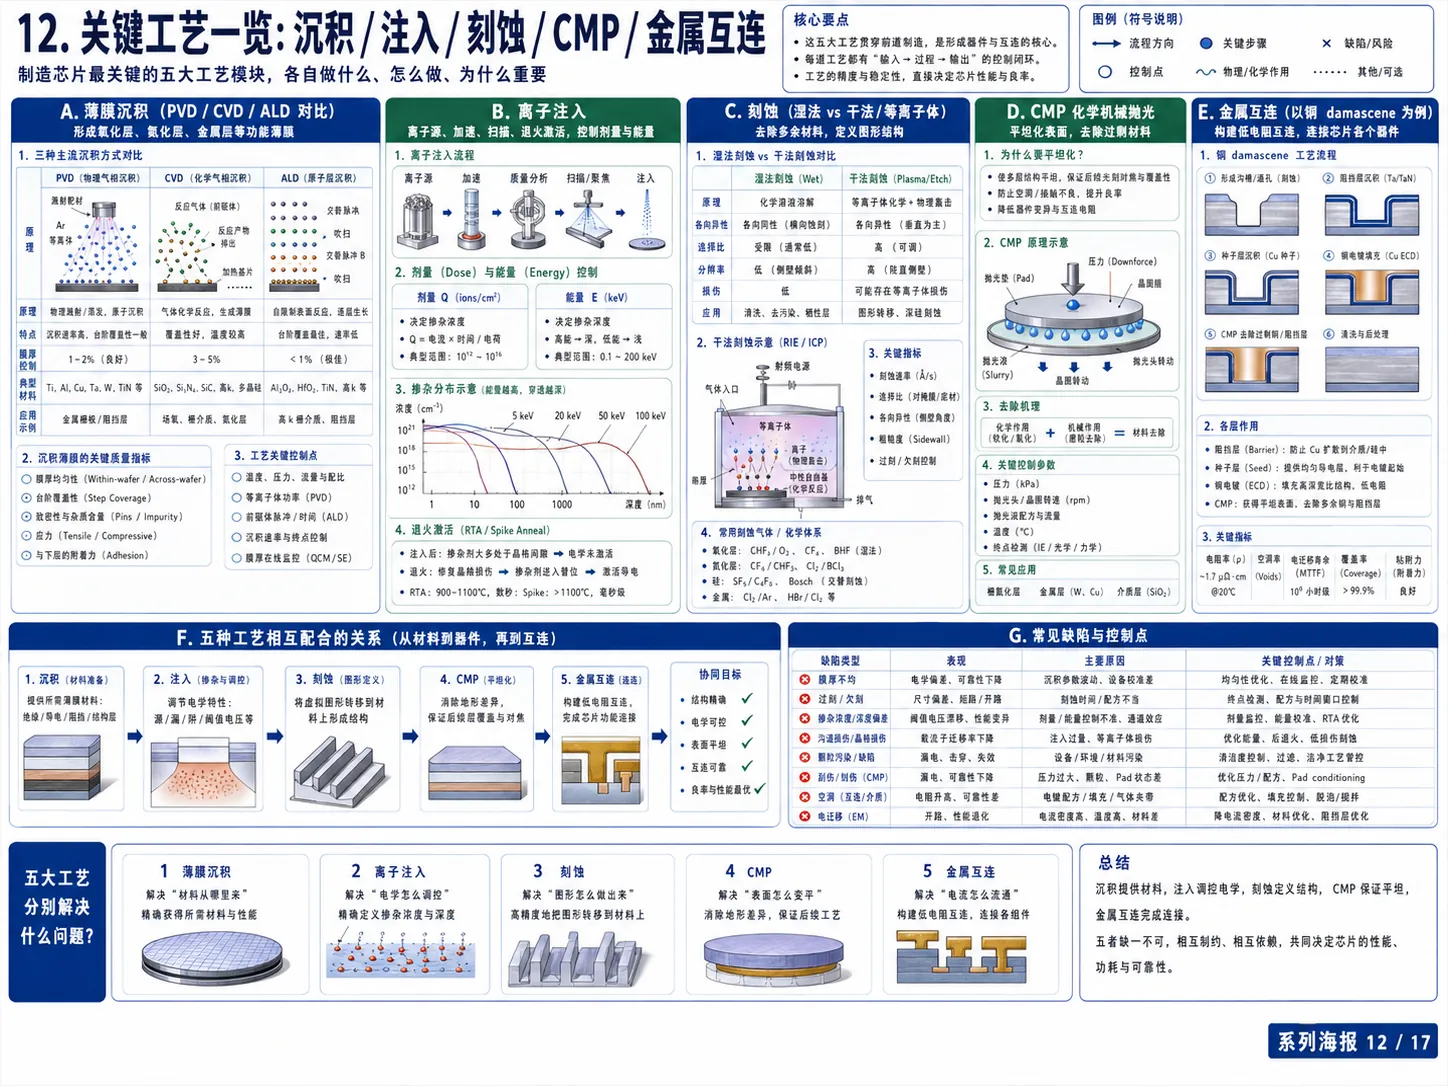
关键制造工艺:沉积、离子注入、刻蚀、CMP 和金属互连分别负责堆叠材料、改变电性、塑造结构、表面平坦化与连接器件。
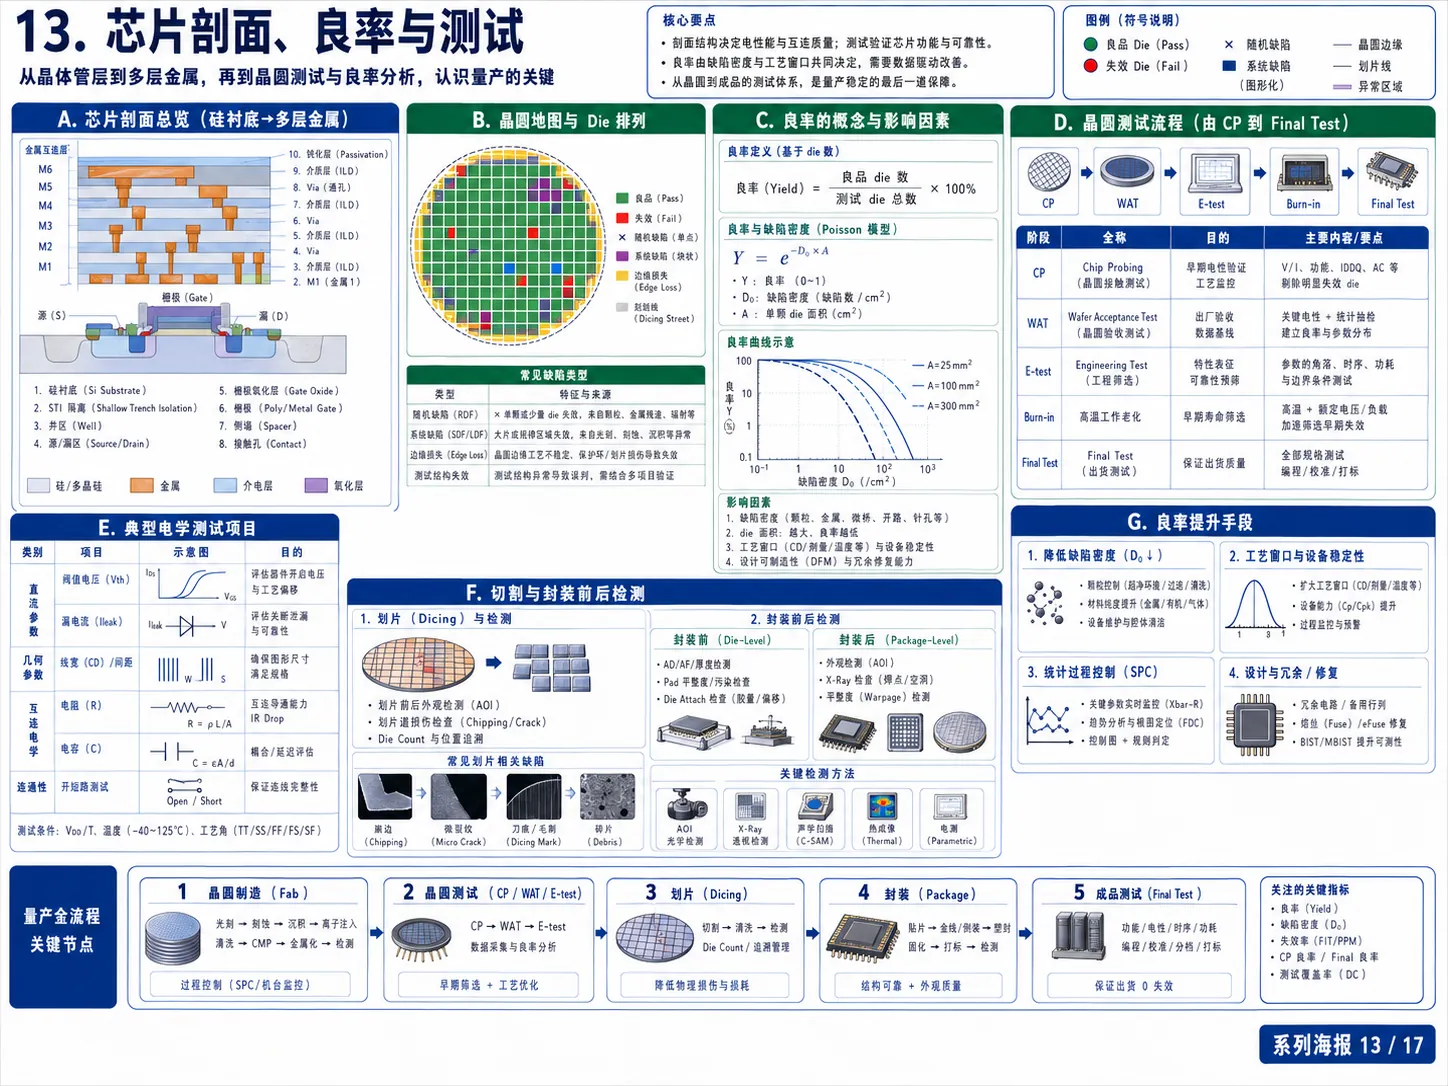
芯片剖面、良率与测试:从多层互连结构观察芯片实体,并通过晶圆测试、切割、封装和成品测试筛选合格芯片。
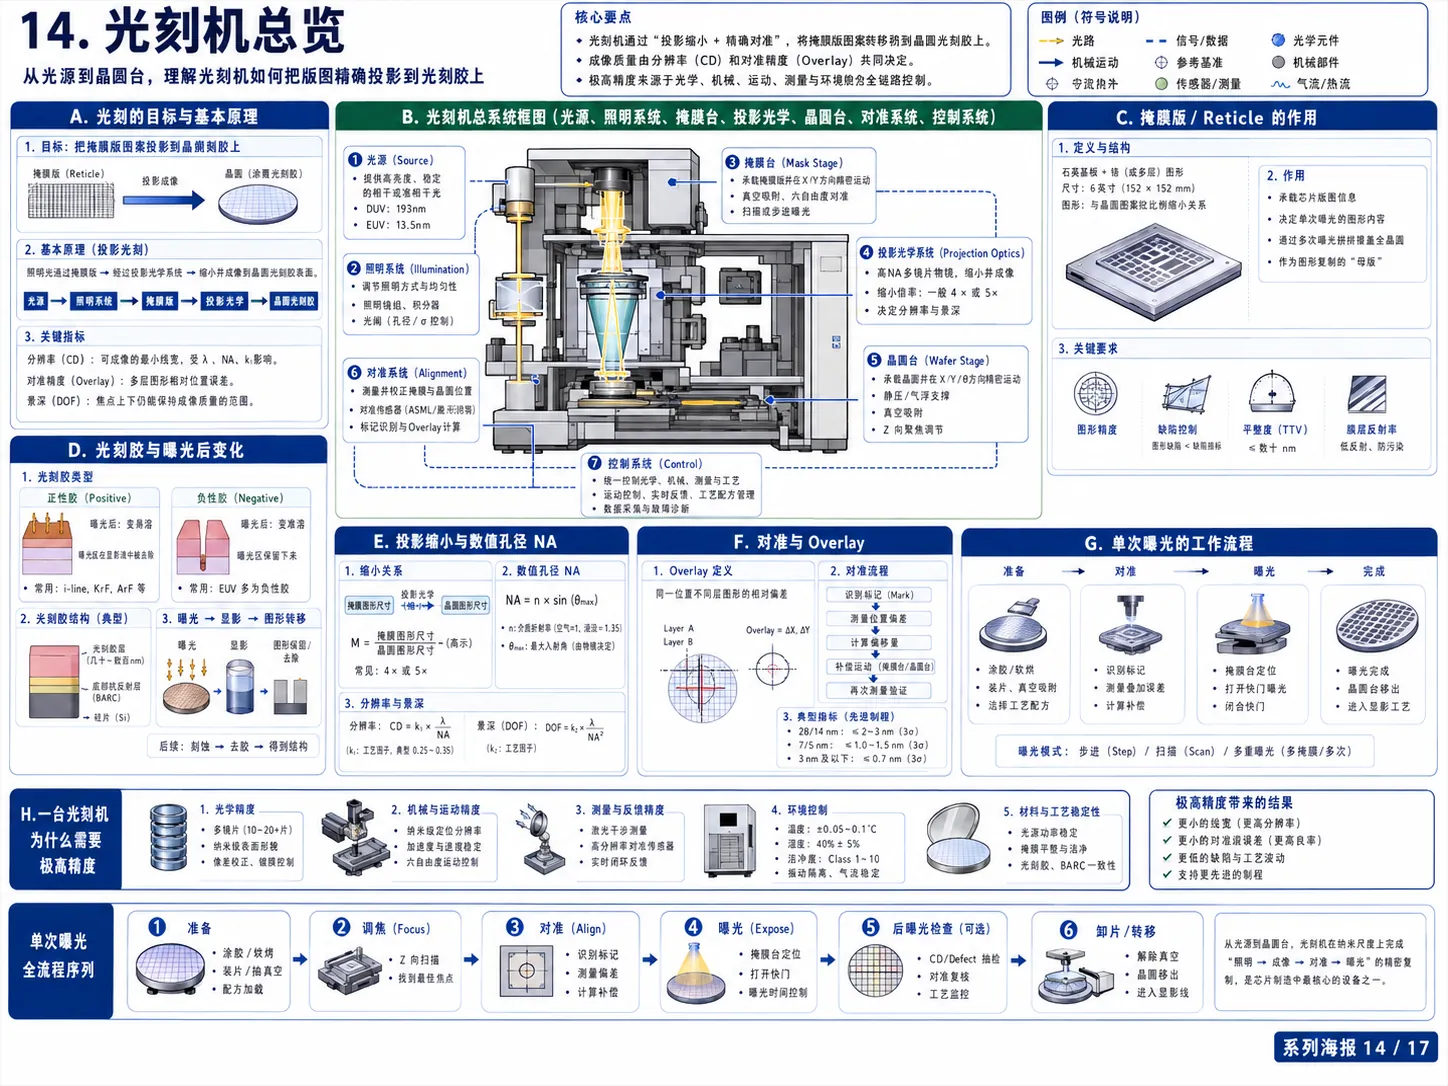
光刻机总览:光源经照明、掩膜、投影物镜和晶圆台完成图形曝光,其精度取决于光学、机械与控制系统的协同。
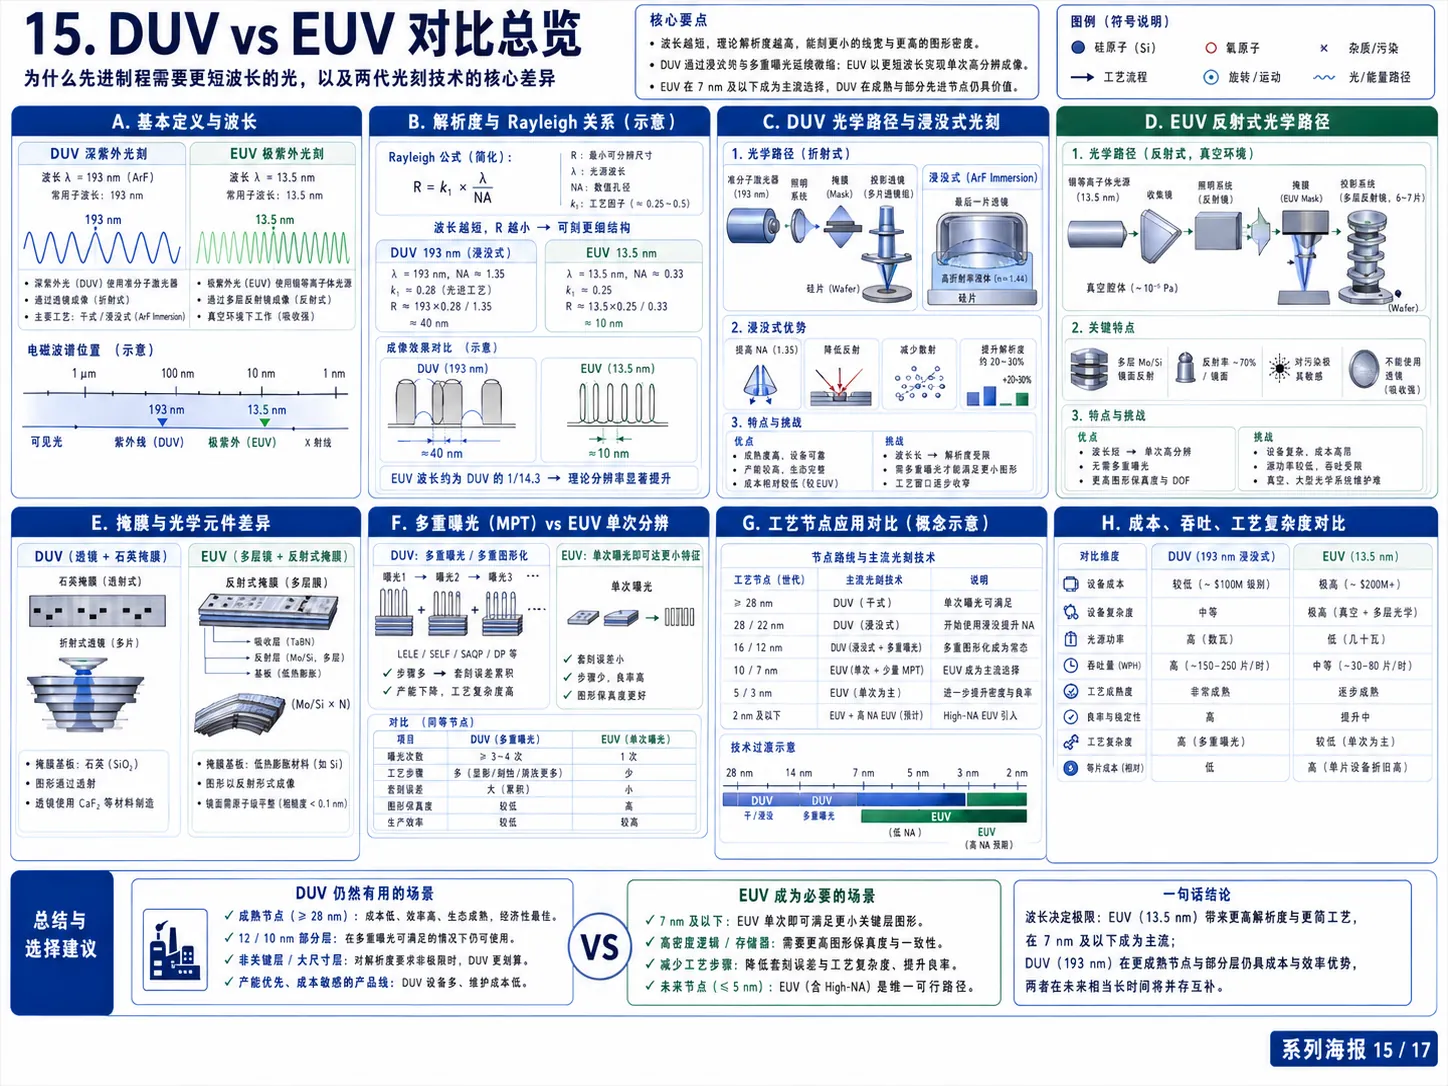
DUV 与 EUV 对比:更短波长的 EUV 能获得更高分辨率并减少多重曝光,但设备、光源、真空环境和掩膜体系更复杂。
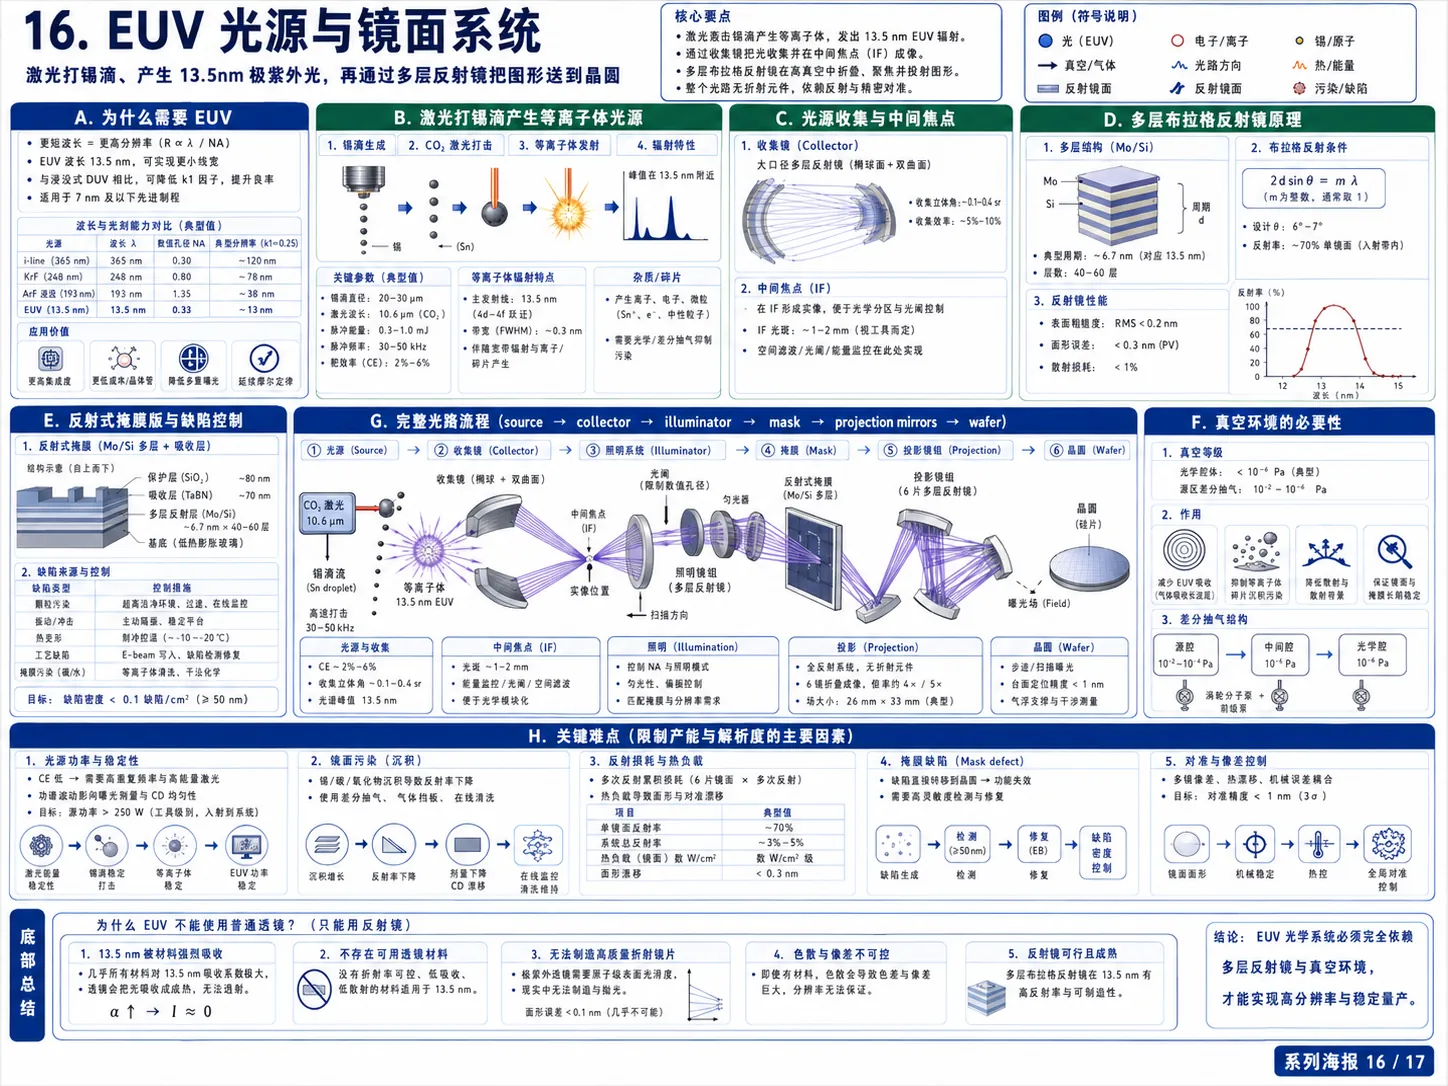
EUV 光源与镜面系统:激光轰击锡滴产生 13.5 纳米极紫外光,再由多层反射镜收集、整形并投射到晶圆。
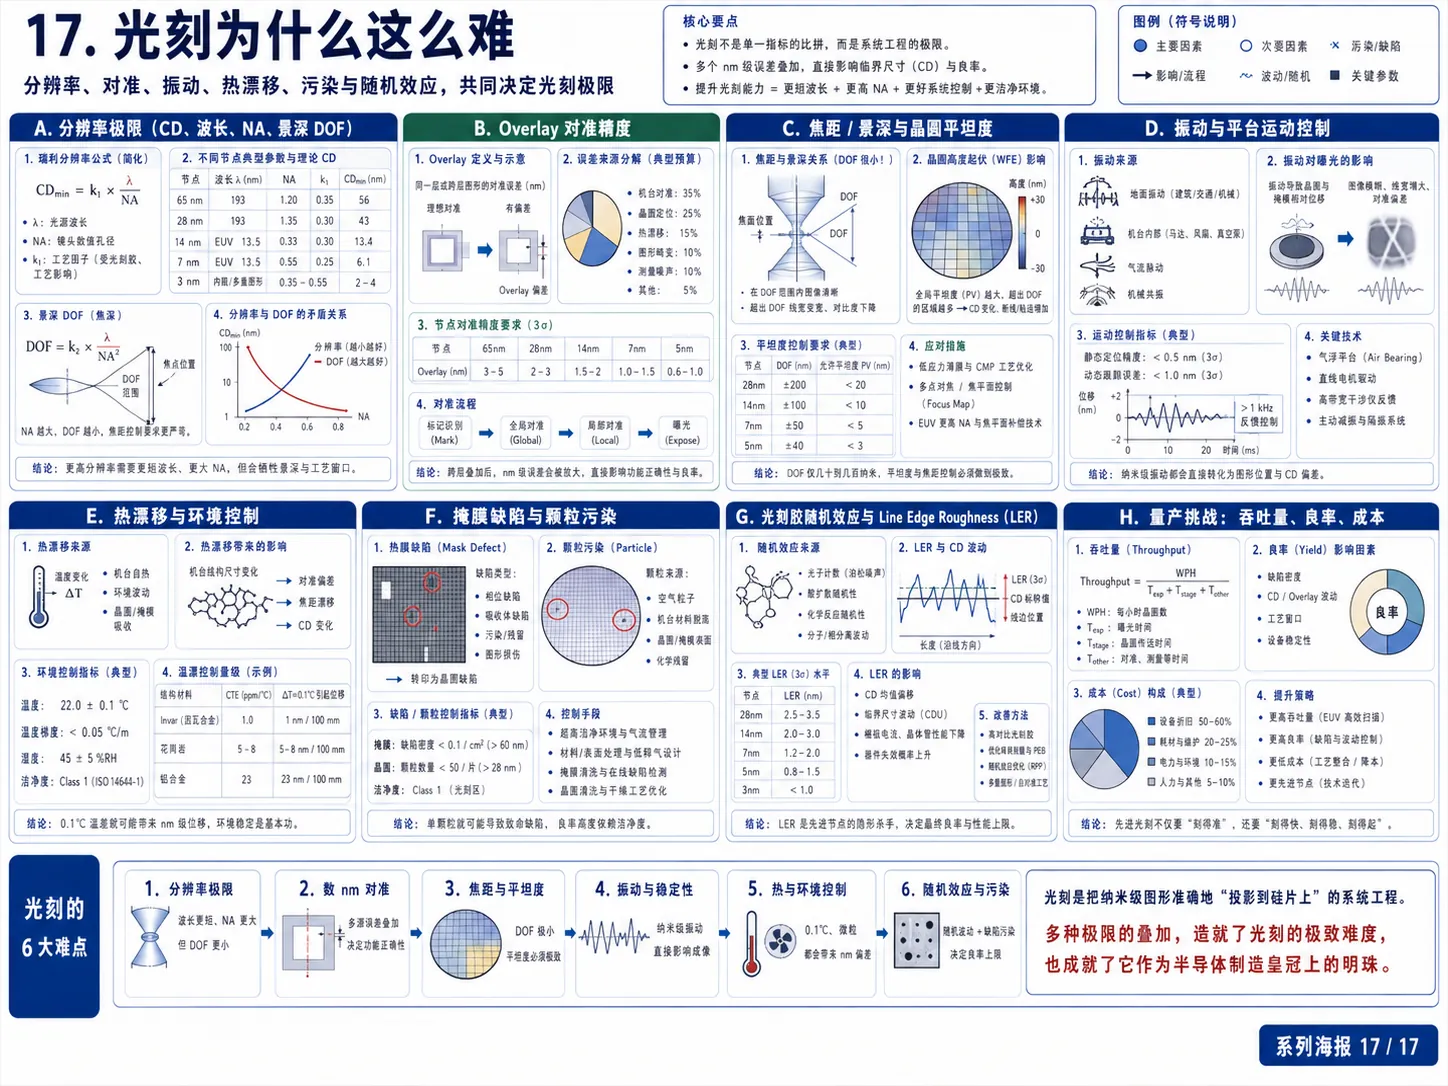
光刻为何困难:分辨率、套刻精度、焦深、热漂移、颗粒污染和随机缺陷相互制约,共同决定光刻良率和成本。
三、先进制程与先进封装
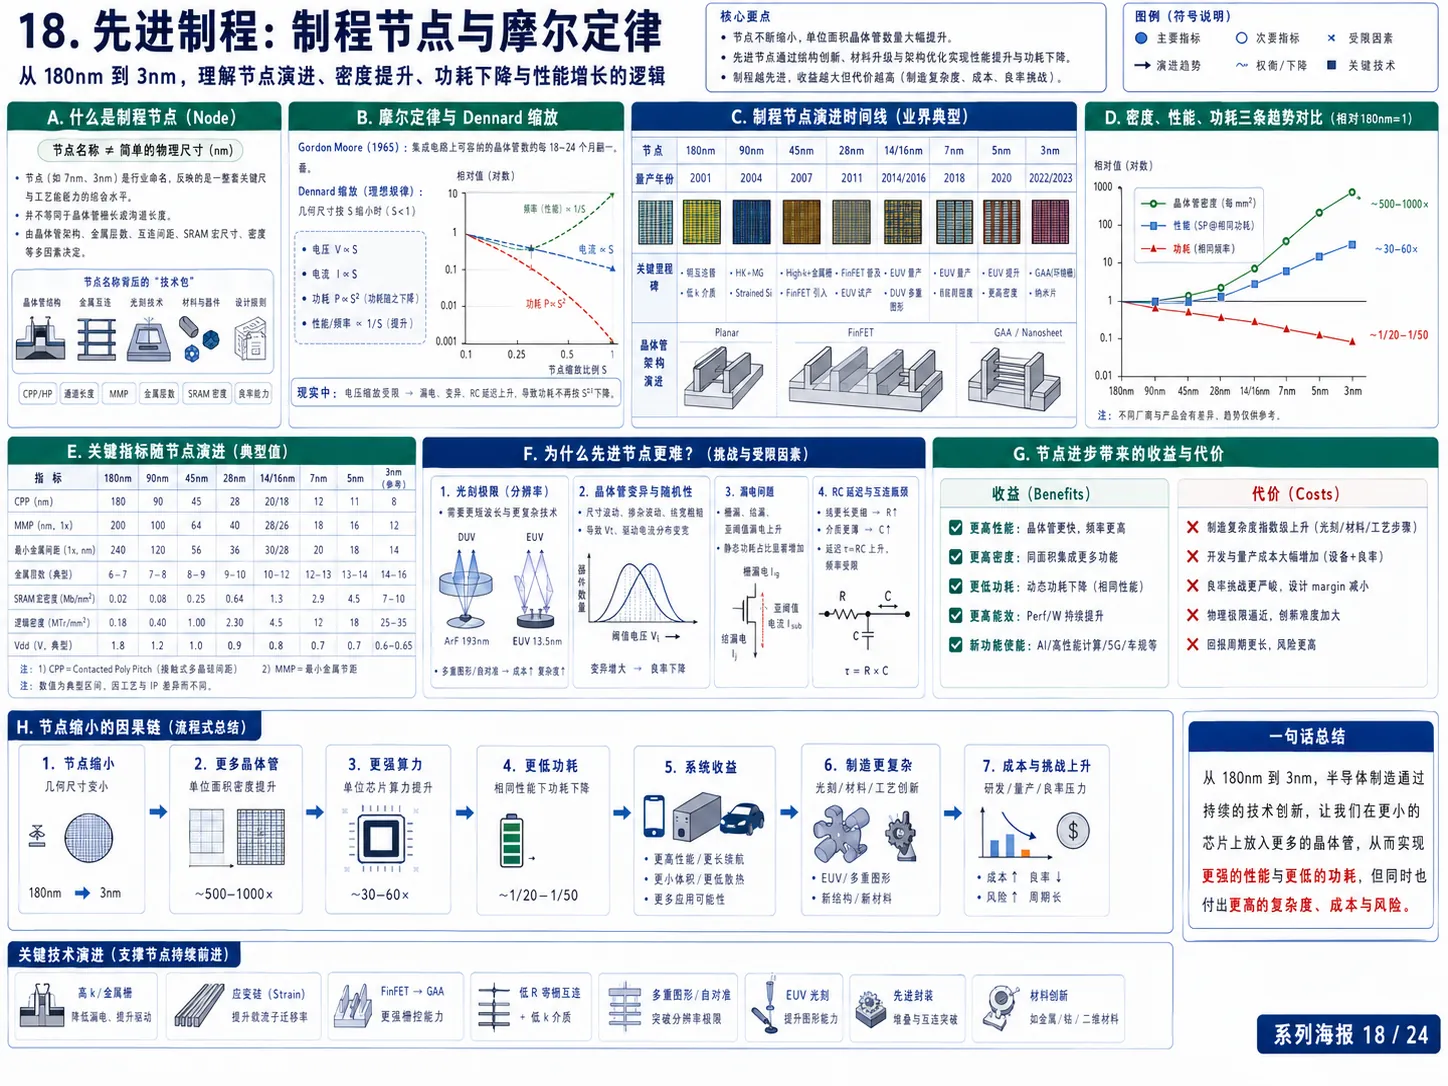
先进制程与摩尔定律:制程节点持续缩小带来更高密度和更低功耗,同时也推高设备、研发、掩膜和晶圆制造成本。
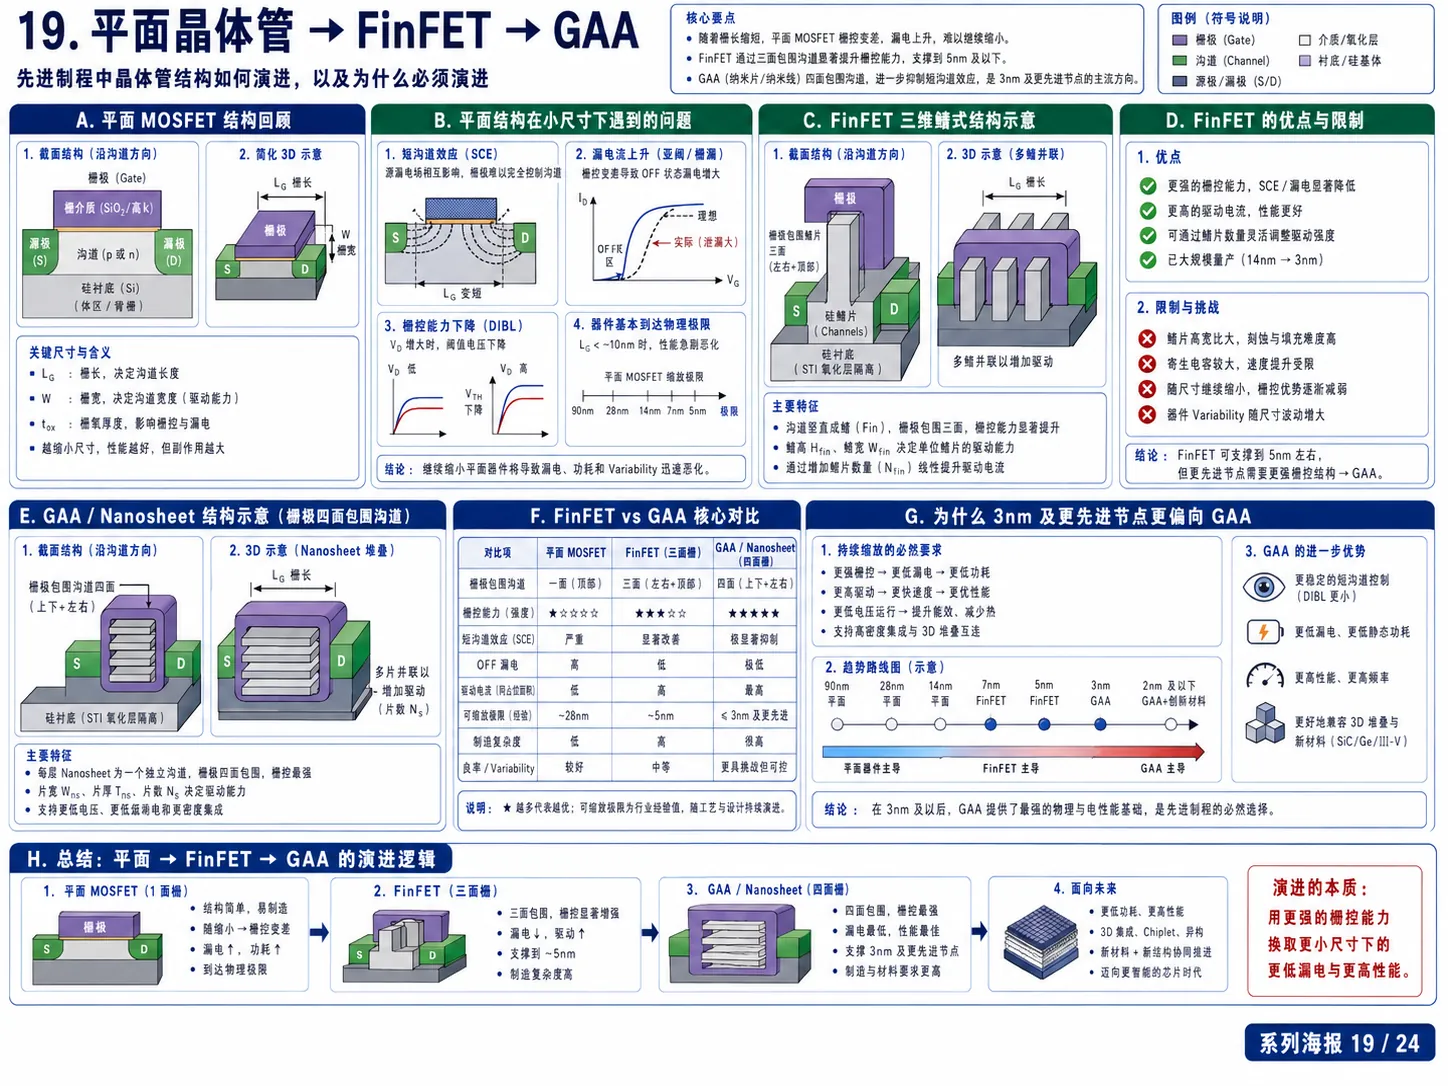
平面晶体管到 FinFET 再到 GAA:栅极对沟道的包围程度不断提高,以改善短沟道效应、漏电和静电控制能力。
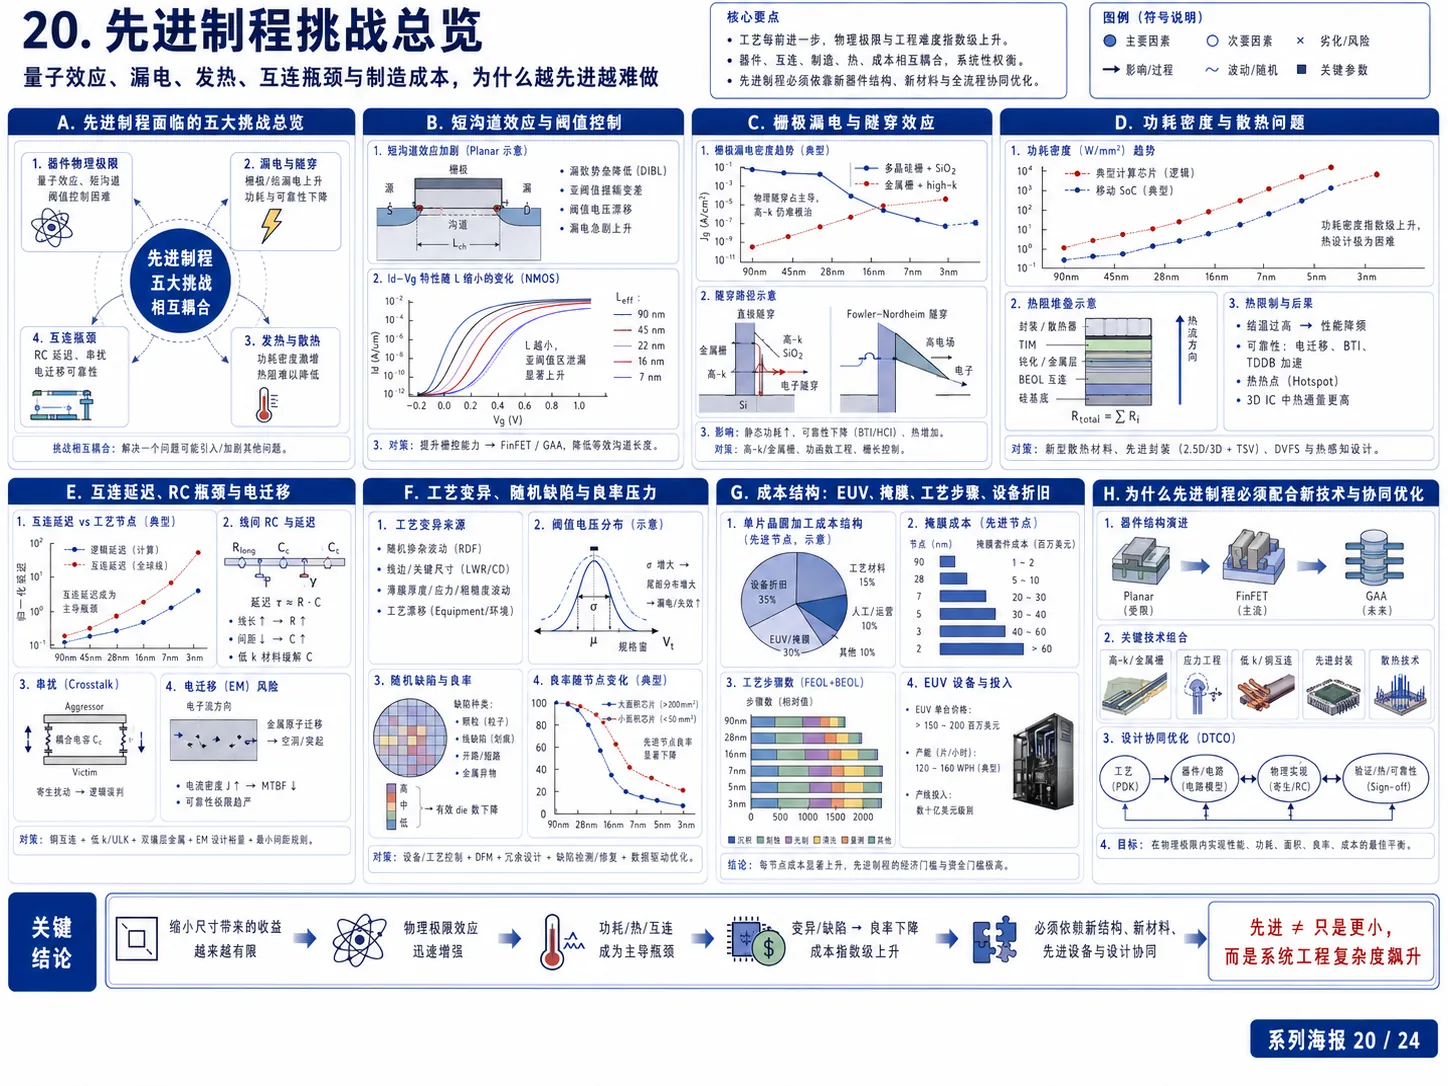
先进制程挑战总览:量子效应、互连延迟、功耗密度、工艺复杂度与巨额成本,让节点演进成为系统工程。
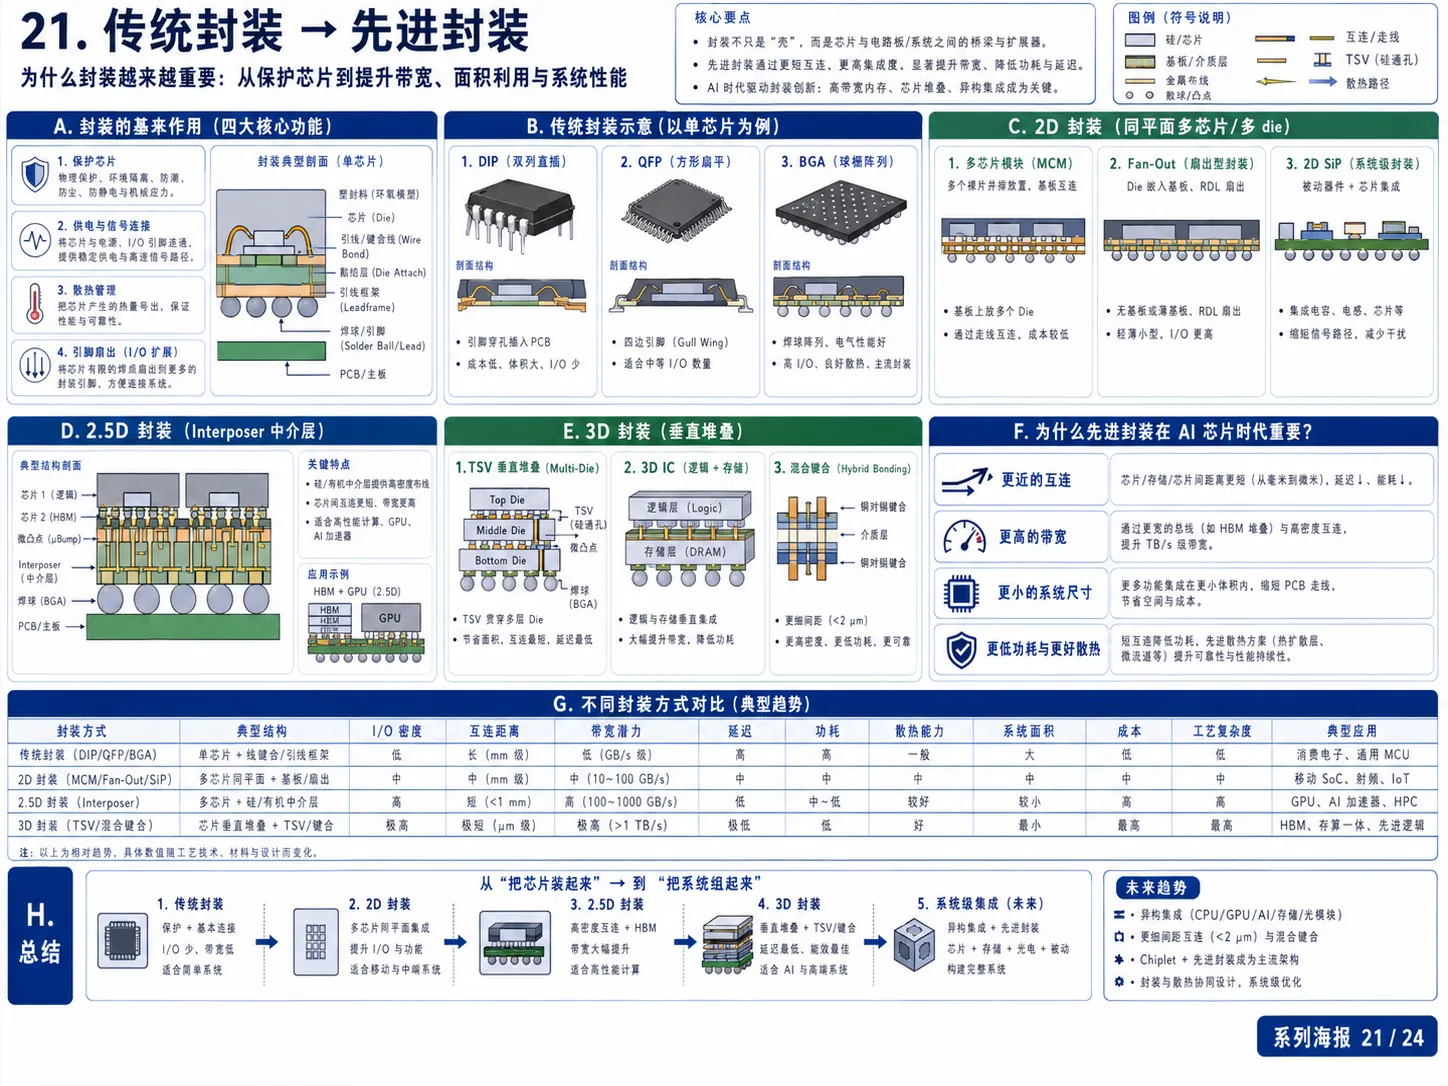
传统封装到先进封装:封装从保护裸片和引出信号,演进为提升互连密度、带宽、散热与系统集成度的关键技术。
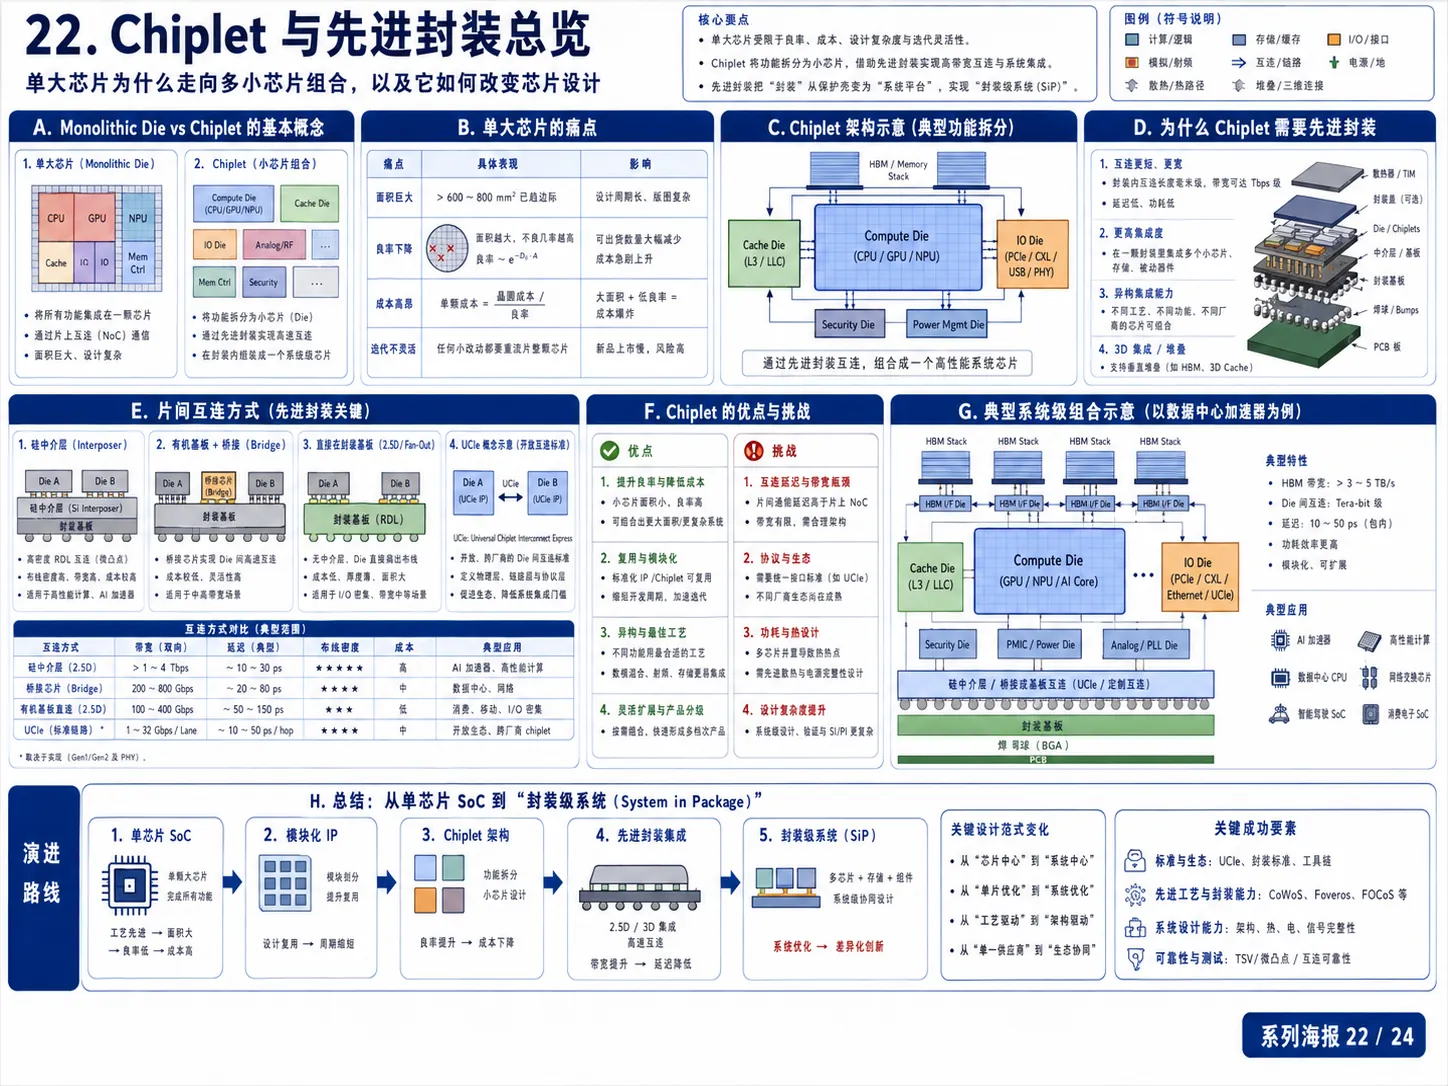
Chiplet 与先进封装:将大型单片芯片拆成多个功能小芯粒,再通过 2.5D、3D 和高速互连组合成完整系统。
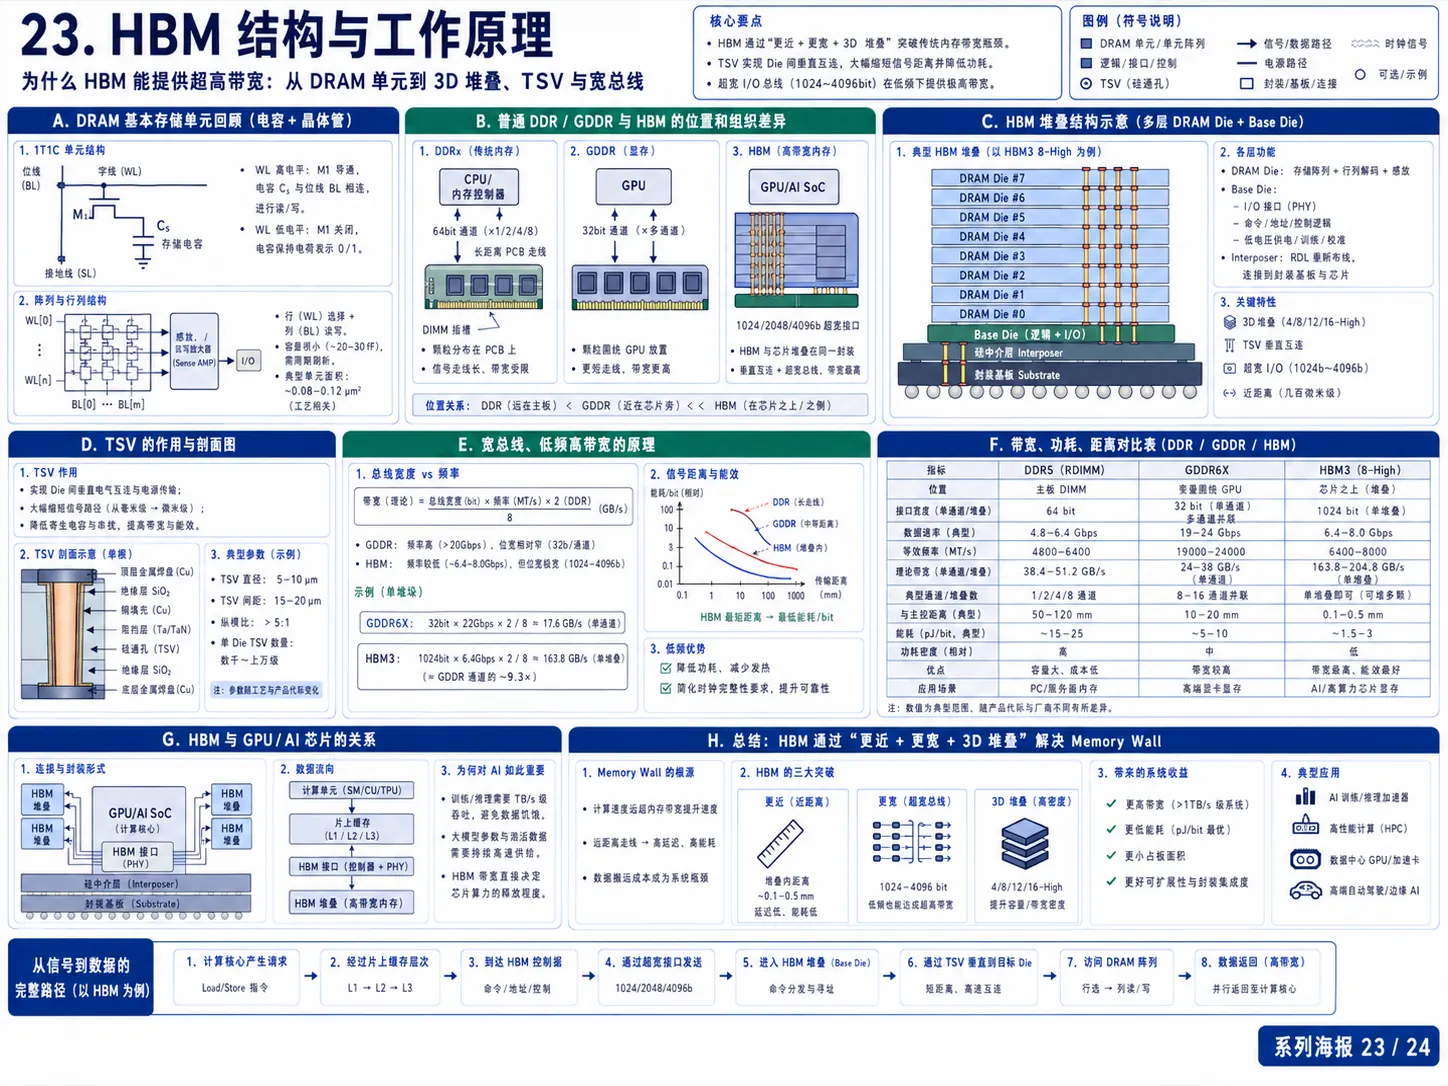
HBM 结构与工作原理:多层 DRAM 通过 TSV 垂直堆叠并采用超宽接口,为 AI 加速器提供高带宽、低功耗的近端内存。
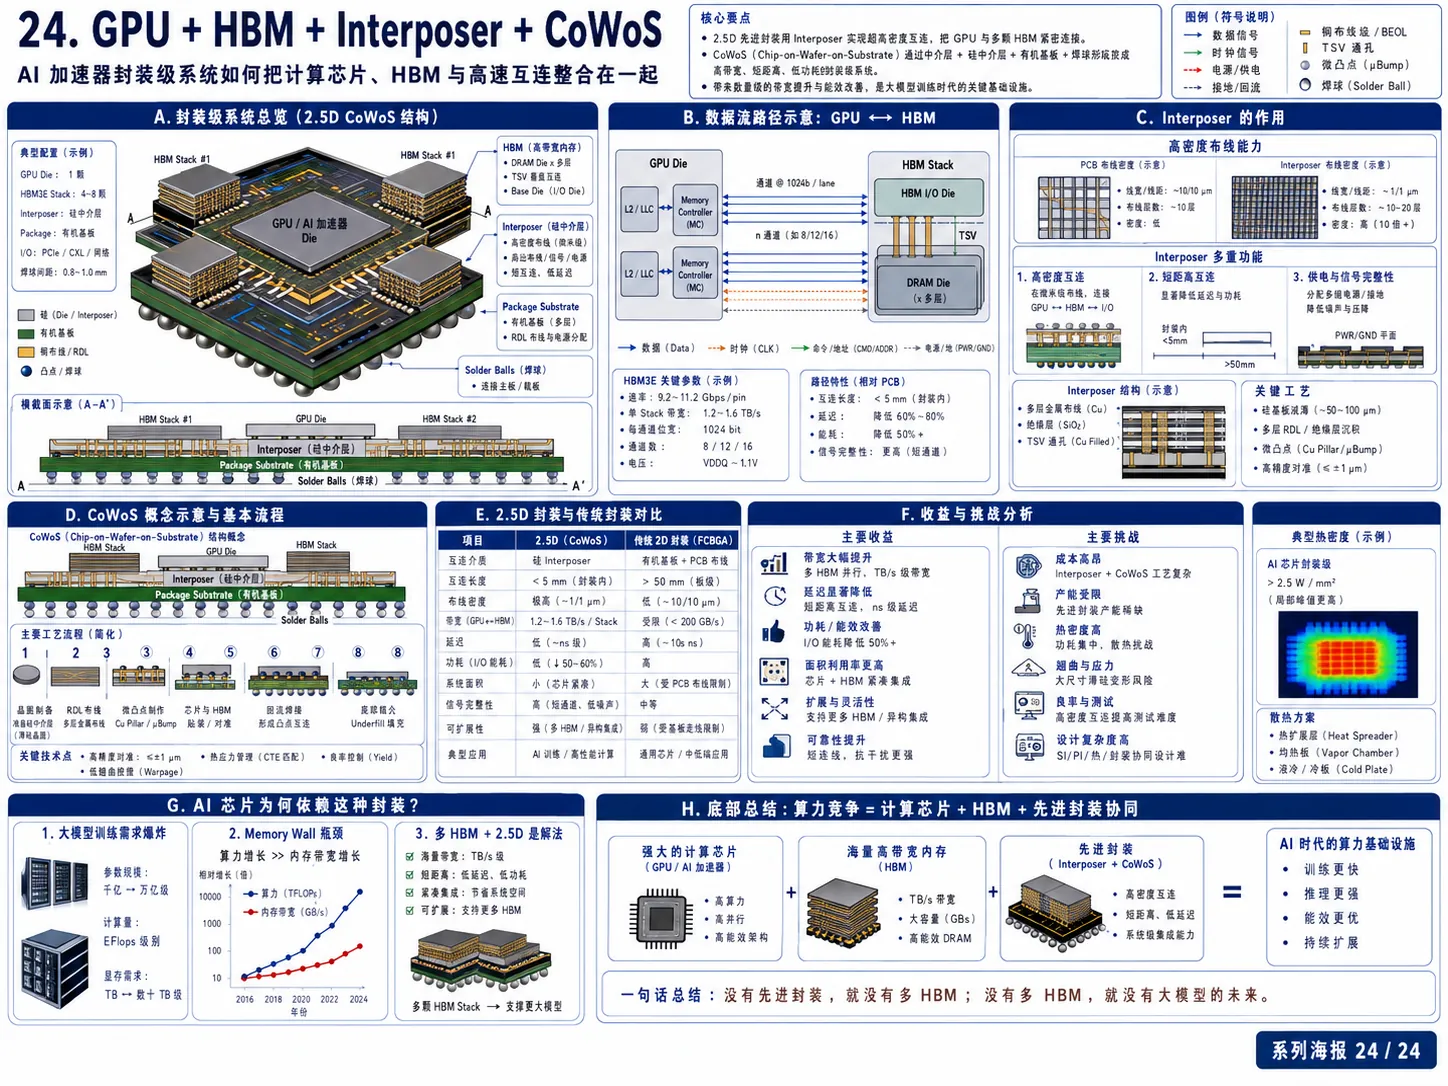
GPU、HBM、Interposer 与 CoWoS:中介层把计算芯片与多组 HBM 高密度互连,再由先进封装完成供电、散热和外部连接。
四、AI 芯片与服务器系统
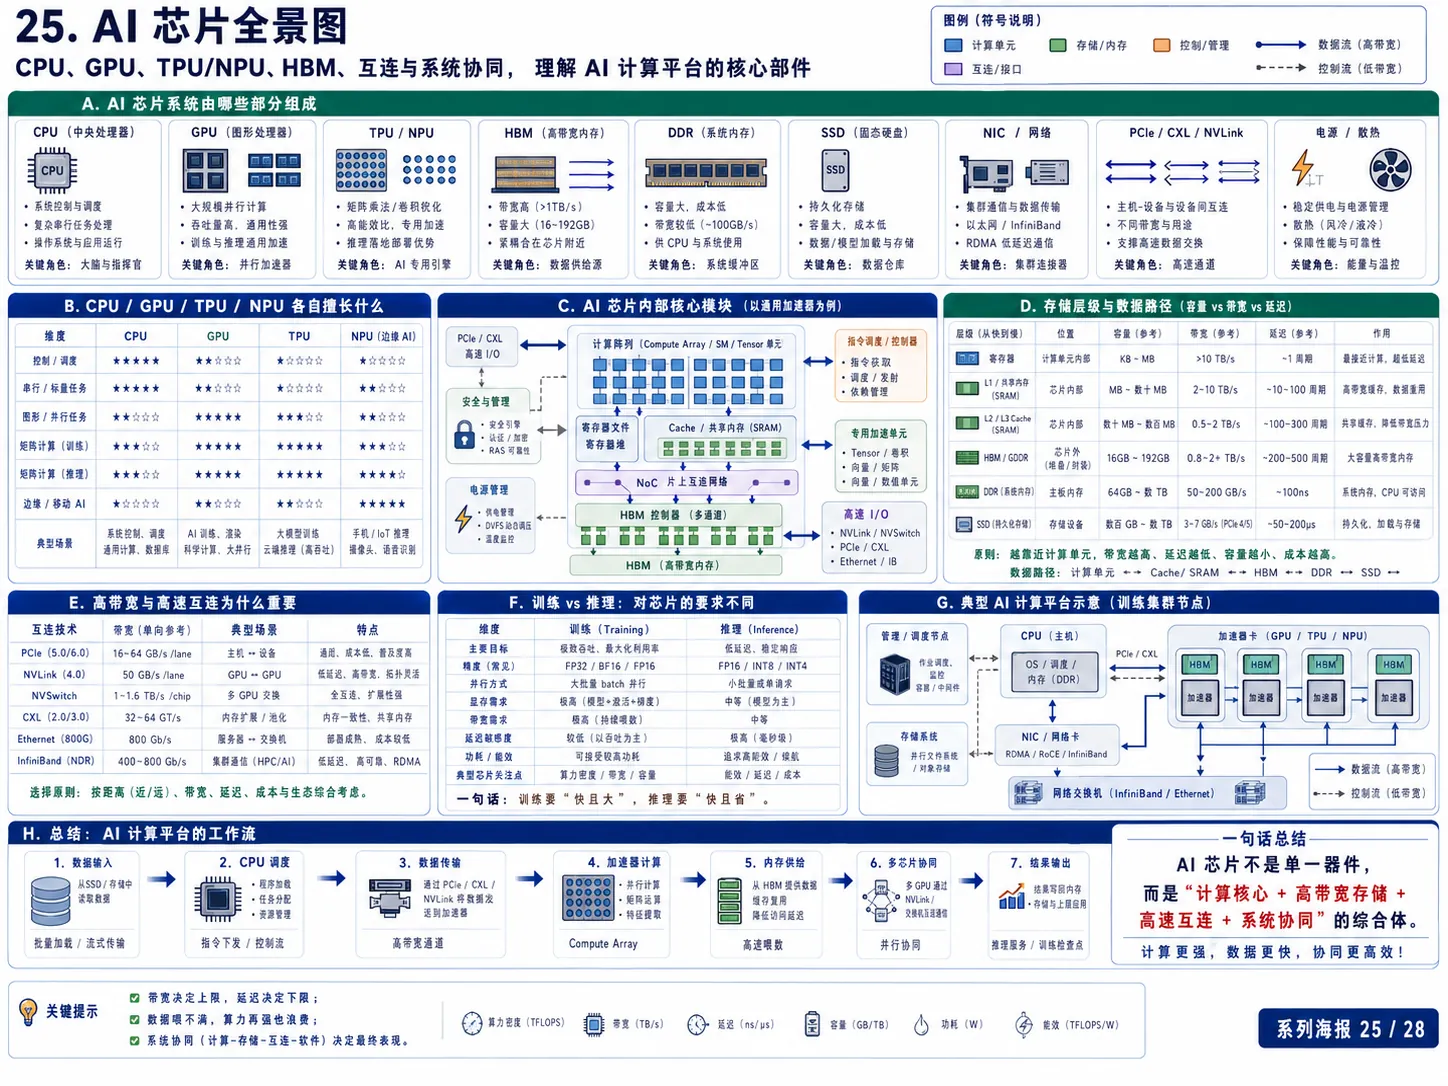
AI 芯片全景:CPU、GPU、TPU 或 NPU、HBM、存储、网络和高速互连共同构成完整的 AI 计算平台。
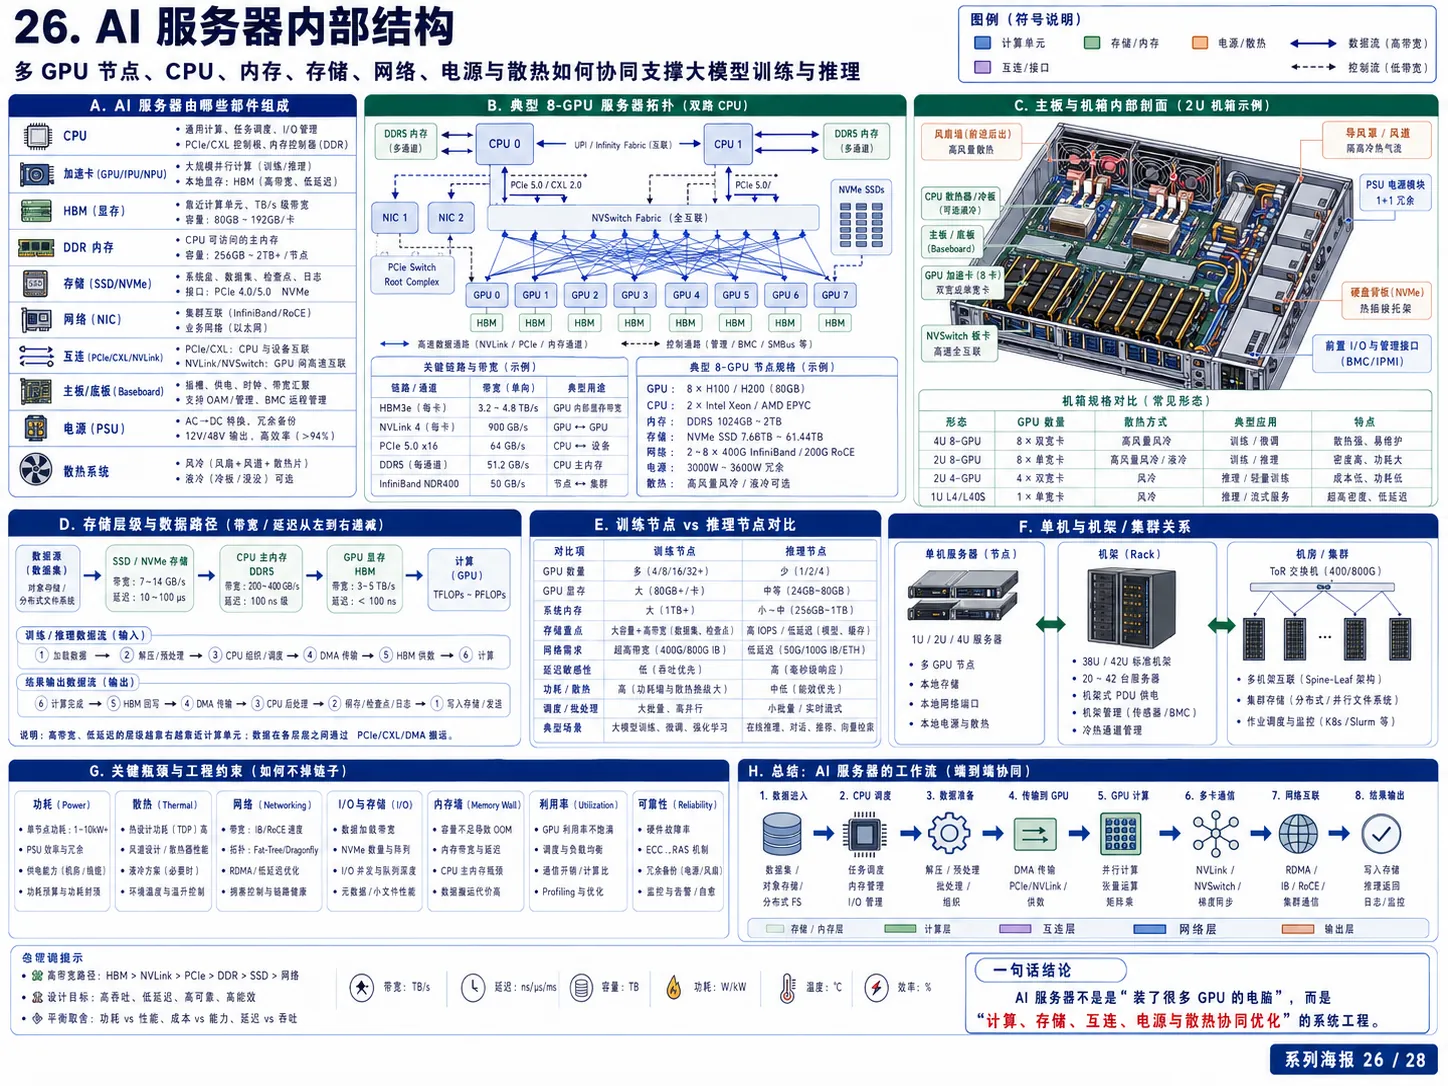
AI 服务器内部结构:多颗 GPU 通过 NVLink 或高速交换网络互连,并与 CPU、内存、存储和网卡协同支撑训练与推理。
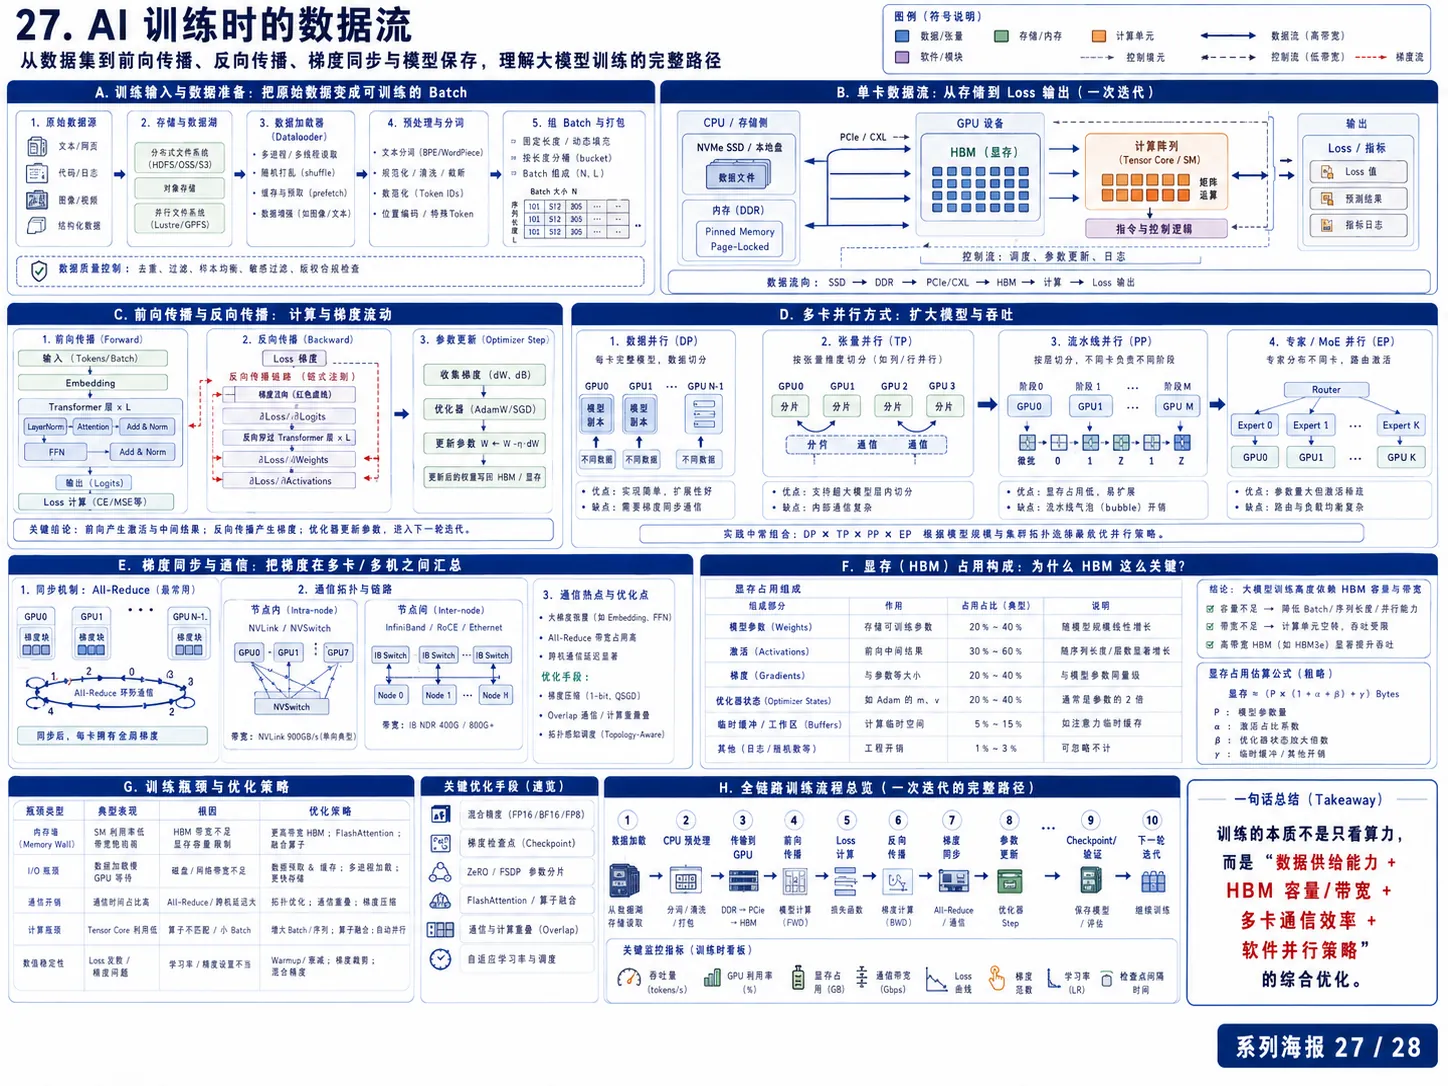
AI 训练时的数据流:数据经过加载与预处理进入 GPU,完成前向计算、反向传播、梯度同步和参数更新,并循环直至收敛。
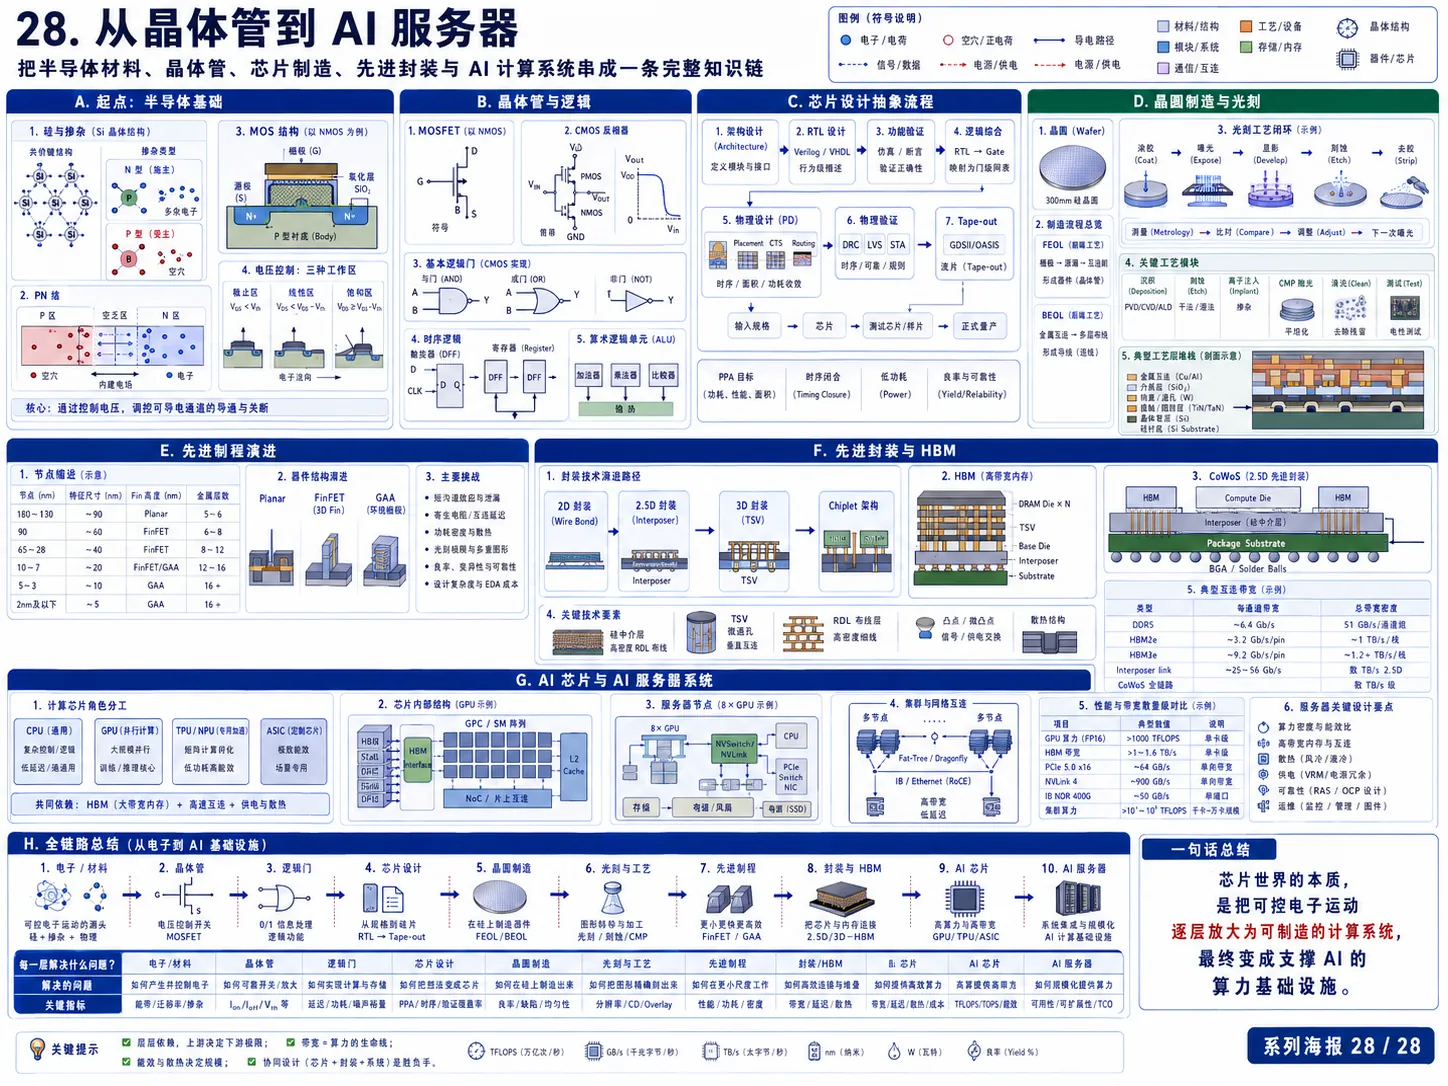
从晶体管到 AI 服务器:材料、器件、芯片设计、晶圆制造、先进封装和系统互连层层协作,最终形成可用的 AI 算力基础设施。